今更ですが今年の2月に spaCy 3.0 が公開されました。 3.0 で導入された新機能の中で目玉と言えるのは、やはり Hugging Face Transformers (以下、単にTransformers) のサポートや PyTorch, Tensorflow との連携になるでしょう。今回はその辺りを実際に学習を動かしながら紹介したいと思います。
1. はじめに
今回は今年の2月に公開された spaCy 3.0 の話です。 spaCy は第4回でも紹介しましたが、研究者向けというよりは自然言語処理アプリ開発者向けのオープンソース自然言語処理ライブラリになります。日本語を含めた様々な言語の学習済みモデルが存在しており、 spaCy をインストールして、学習済みモデルをダウンロードするだけで、分かち書き、品詞や依存関係の推定、単語や文の類似度の判定など様々な機能を使用することができます。
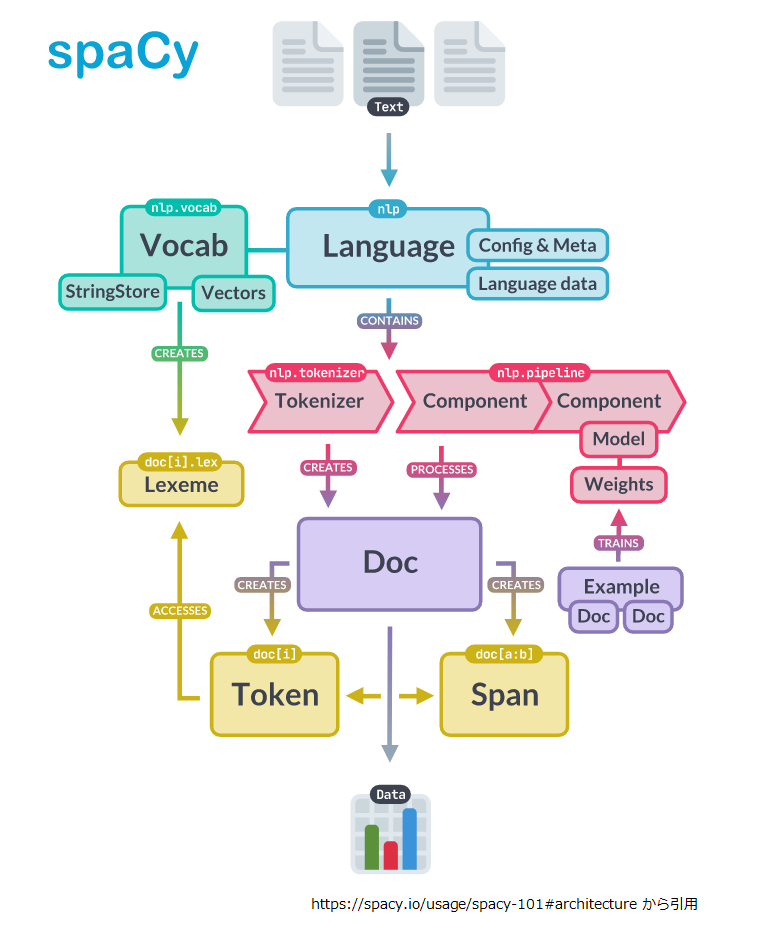
上記のイメージ図を見る分には、この辺りの基本的なところは 2.x から大きく変わってなさそうなので1、第4回の記事を参照していただければよいかと思います。
さて、 spaCy 3.0 で導入された新機能の目玉と言えるのは、やはり Transformers のサポートや PyTorch, Tensorflow との連携になるでしょう。 あくまで個人的な感覚ですが、 2.x のときは公開されているモデルをダウンロードして、そのままアプリをガシガシ組む為のモノという印象だったのですが、3.0 は学習周りがかなり強化され、使いやすくなった印象です。
Transformers がサポートされることで SOTA なモデルを spaCy から利用できるようになったのですが、残念ながら現在公開されている日本語モデルには Transformer ベースのものがありません。。。
そんな訳なので今回は Transformer ベースの日本語モデルを作成し、どの程度の精度がでるのか見てみたいと思います。
2. Transformers の利用
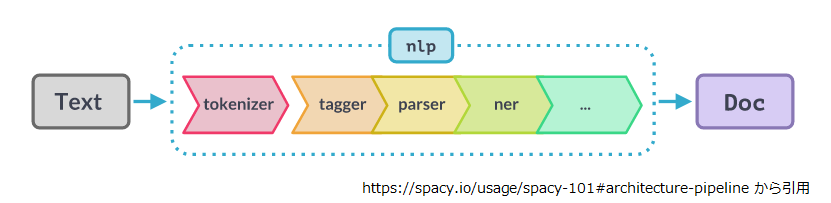
本題に入る前に少し spaCy の構造の復習をしておきましょう。 spaCy は以下のように複数のコンポーネントが数珠繋ぎになったパイプラインアーキテクチャを採用しています。tagger(品詞推定)、parser(係り受け解析)等、各コンポーネントは文字列から変換した Doc をバケツリレーしつつ属性を追加していきます。 ただし、 tokenizer だけは str -> Doc の変換を担う為、特殊な立ち位置になります。
spaCy には以前から tokenizer で分割した Token から特徴量を抽出する tok2vec というコンポーネントが存在していました。 spaCy での Transformers の利用は、この toc2vec を Transformers で置き換える形になります。
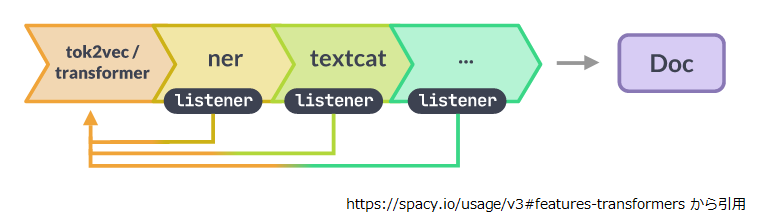
ner(固有表現抽出) や textcat(文章分類) 等の後続のコンポーネントは transformer (ややこしいですが、 Transformers を内包した spaCy のコンポーネントです) が出力した各トークン毎の特徴量を入力として各々の学習や推論をする形になります。 transformer は重い処理になるので、listener を経由して transformer で一度処理をすれば複数のコンポーネントで処理結果を共用できる構造になっています2。
また、この構造で学習を行う場合、 transformer は listener を経由して後続のコンポーネントから勾配情報を受け取るマルチタスク学習になります。
ただ Transformers で提供されるモデルはそれぞれトークナイザを持っています。 BertJapaneseTokenizer であればテキストを MeCab で単語に分けて、それを更にサブワードに分割します。 spaCy は spaCy で tokenizer がパイプラインの先頭に鎮座しており、日本語であれば標準で分割モード “A” の SudachiPy が使用されます。
この辺りの整合性が気になってきたので、そのあたりを少し確認しておきましょう。
単語とサブワードの対応付け
ここからは話がややこしくならないよう、「Transformers のトークンナイザはテキストをサブワードに分割する」という前提で記述しますね3。
transformer コンポーネントのソースコード的にはこの辺りが該当箇所になります。
https://github.com/explosion/spacy-transformers/blob/015daa34efbf2202b56080954832d029b99f821a/spacy_transformers/layers/transformer_model.py#L123-L147
123:    nested_spans = get_spans(docs)
124:    flat_spans = []
125:    for doc_spans in nested_spans:
126:        flat_spans.extend(doc_spans)
127:    # Flush the PyTorch cache every so often. It seems to help with memory :(
128:    # This shouldn't be necessary, I'm not sure what I'm doing wrong?
129:    maybe_flush_pytorch_cache(chance=model.attrs.get("flush_cache_chance", 0))
130:    if "logger" in model.attrs:
131:        log_gpu_memory(model.attrs["logger"], "begin forward")
132:    batch_encoding = huggingface_tokenize(tokenizer, [span.text for span in flat_spans])
133:    wordpieces = WordpieceBatch.from_batch_encoding(batch_encoding)
134:    if "logger" in model.attrs:
135:        log_batch_size(model.attrs["logger"], wordpieces, is_train)
136:    align = get_alignment(
137:        flat_spans, wordpieces.strings, model.attrs["tokenizer"].all_special_tokens
138:    )
139:    wordpieces, align = truncate_oversize_splits(
140:        wordpieces, align, tokenizer.model_max_length
141:    )
142:    tensors, bp_tensors = transformer(wordpieces, is_train)
143:    if "logger" in model.attrs:
144:        log_gpu_memory(model.attrs["logger"], "after forward")
145:    output = FullTransformerBatch(
146:        spans=nested_spans, wordpieces=wordpieces, tensors=tensors, align=align
147:    )
- 132行目:
ここでDocに滑走窓を適用して生成したSpanをテキストに戻したうえで、Transformers のトークナイザでサブワード単位に分割しています。 - 136行目:
ここでSpan(中身は単語単位のTokenに分割されている) と先ほどのサブワード分割結果の対応関係を計算します。
136行目を追っていくと以下の行にたどり着きました。ここアライメント計算の本体になります。
https://github.com/explosion/spacy-transformers/blob/015daa34efbf2202b56080954832d029b99f821a/spacy_transformers/align.py#L161
161:        span2wp, wp2span = get_alignments(sp_toks, wp_toks_filtered)
ちょっと意地悪なサンプルで試してみました。
import spacy_alignments as tokenizations
a2b, b2a = tokenizations.get_alignments(["新横浜", "駅前"], ["新", "横浜駅", "前"])
print(a2b)
print(b2a)
# [[0, 1], [1, 2]]
# [[0], [0, 1], [1]]
これなら、単語一つがサブワード二つに分かれるケース(“新横浜”=>“新”, “横浜駅”)、サブワード一つが単語二つに由来するケース(“横浜駅”<=“新横浜”, “駅前”)、共に問題なさそうですね。
さて、上記のコードでテキストをサブワード単位に分割して、サブワード単位の特徴量を得るところまできました。ですが、spaCy の後続コンポーネントは Token 単位での特徴量を期待しているので、そこのすり合わせ箇所も見ておきましょう。
上記のコードの145~147行目を見ると transformer コンポーネントが返すのは、単語単位に分割された Span, サブワード単位の分割結果、サブワード単位の特徴量、単語とサブワードのアライメント情報になります。ですから、サブワード単位の情報を丸めるのはもう少し先ですね。
先ほど紹介した listener のコードにその処理が入っていました。
https://github.com/explosion/spacy-transformers/blob/015daa34efbf2202b56080954832d029b99f821a/spacy_transformers/architectures.py#L10-L13
10: @registry.architectures.register("spacy-transformers.TransformerListener.v1")
11: def transformer_listener_tok2vec_v1(
12:     pooling: Model[Ragged, Floats2d], grad_factor: float = 1.0, upstream: str = "*"
13: ) -> Model[List[Doc], List[Floats2d]]:
..: ...
26:     pooling (Model[Ragged, Floats2d]): A reduction layer used to calculate
27:         the token vectors based on zero or more wordpiece vectors. If in doubt,
28:         mean pooling (see `thinc.layers.reduce_mean`) is usually a good choice.
listener のファクトリ関数に pooling を指定できるようになっており、ここで単語単位に丸めています。
pooling はタイプヒントで示されているように、Ragged を受け取り Floats2d にして返します。
Ragged は 長さの異なるシーケンスを一まとめにしたデータ形式で、全シーケンスのデータを保持するベクトルと各シーケンスの長さを保持するベクトルを持ちます。この箇所ではシーケンスが Doc から抽出した各 Span に対応し、transformer から出力された特徴量が Doc 一つ分詰め込まれることになります。
うーん、よくわからない説明ですね。。。サブワード “X” に対応する transfomer の出力を “{X}” で表記すると、"spaCyはオープンソースの自然言語処理ライブラリです。"という単一の Doc を投入した場合のイメージが以下のようになります。4
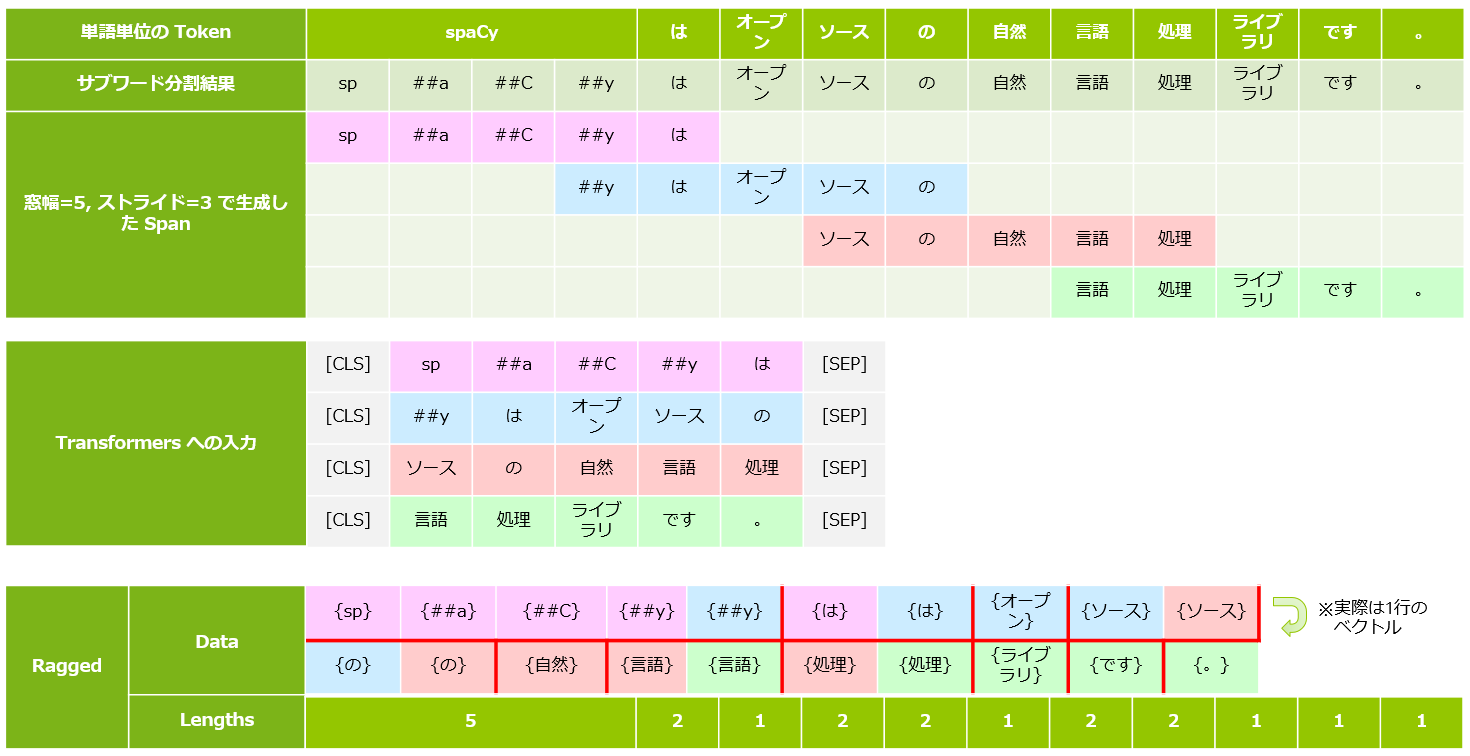
Floats2d は二次元浮動小数点配列で [Doc の Token数、transformerの特徴量の次元数(BERTBASEなら768)] のシェイプになります。
reduce_mean で丸めるなら上図最下段の赤枠の範囲で特徴量の平均を取った結果になります。
だいぶ脱線してしまったので、さっそく動かしてみましょう。
3. Transformers ベースのパイプラインの学習
ここからは実際にパイプラインの学習をしていきます。今回も Colab で動かす想定でコードスニペットを入れていくので、 新たにノートブックを開き、アクセラレータは GPU を選んでおいて下さい。
セットアップ
spaCy をインストールします。
!pip install -U spacy[cuda110,transformers,lookups,ja]
Transformers のモデルには東北大さんの日本語 BERT を使うので MeCab 関係を入れておきます。
!apt-get install mecab mecab-ipadic-utf8
!pip install mecab-python3 fugashi ipadic
このまま続けていくと以下のようなエラーに出くわしました。真面目に解決するのも面倒だったのでランタイムを再起動してしまいました。
ContextualVersionConflict: (sortedcontainers 2.3.0 (/usr/local/lib/python3.7/dist-packages), Requirement.parse('sortedcontainers~=2.1.0'), {'sudachipy'})
学習データの準備
さて学習データに何を使うかです。先ほど、ちらっと書きましたが複数コンポーネントで transformer を共用する場合はマルチタスク学習になります。
今回は parser(係り受け解析), ner(固有表現抽出) をマルチタスク学習することにしたので、両方のアノテーションを含んでいる UD_Japanese-GSD v2.6-NE 5 を使うことにしました。 第12回 でも使いましたね。
UD_Japanese-GSD v2.6-NE を選んだ理由はもう一つあって、データが CoNNL-U フォーマット6で提供されていることです。
spaCy には CoNNL-U フォーマットを spaCy 固有の形式(バイナリにシリアライズされた DocBin)に変換するユーティリティ7が付属するので、作業がラクってことで。
まずは、 github からチェックアウトします。
!git clone https://github.com/megagonlabs/UD_Japanese-GSD
CoNNL-U フォーマットの中身はこんな感じです。フィールド 7, 8 が依存関係のアノテーション、フィールド 10 の MISC 領域の最後に固有表現抽出のラベルがみてとれます。
line = !head -79 UD_Japanese-GSD/ja_gsd-ud-train.ne.conllu  | tail -1
for i, f in enumerate(line[0].split("\t")):
  print("%d, %s" % (i+1, f))
1, 16
2, 揚羽
3, 揚羽
4, PROPN
5, 名詞-固有名詞-人名-一般
6, _
7, 19
8, obl
9, _
10, BunsetuBILabel=B|BunsetuPositionType=SEM_HEAD|LUWBILabel=B|LUWPOS=名詞-固有名詞-人名-一般|SpaceAfter=No|UniDicLemma=アゲハ|NE=U-PERSON
フィールド 4 は品詞のアノテーションです。 spaCy には tagger という品詞推定のコンポーネントがあり、欧米系の言語ではこのコンポーネントを使うのですが、日本語の場合はトークナイザの SudachiPy が品詞推定までやってくれるので、今回は使用しないことにしました。
変換処理は非常に簡単です。
!mkdir -p corpus
!python -m spacy convert ./UD_Japanese-GSD/ja_gsd-ud-train.ne.conllu ./corpus
!python -m spacy convert ./UD_Japanese-GSD/ja_gsd-ud-dev.ne.conllu ./corpus
!python -m spacy convert ./UD_Japanese-GSD/ja_gsd-ud-test.ne.conllu ./corpus

!ls ./corpus
# ja_gsd-ud-dev.ne.spacy    ja_gsd-ud-test.ne.spacy  ja_gsd-ud-train.ne.spacy
念のため、中身を確認しておきましょう。
import spacy
from spacy.tokens import Doc, DocBin

nlp = spacy.blank("ja")

train_data = DocBin()
train_data.from_disk(path="./corpus/ja_gsd-ud-train.ne.spacy")

docs = list(train_data.get_docs(nlp.vocab))

for token in docs[2]:
  print("text=%s head=%d dep=%s ent_type=%s ent_job=%s" % (token, token.head.i, token.dep_, token.ent_type_, token.ent_iob_))
# text=手 head=2 dep=obl ent_type= ent_job=O
# text=に head=0 dep=case ent_type= ent_job=O
# text=持っ head=6 dep=acl ent_type= ent_job=O
# text=た head=2 dep=aux ent_type= ent_job=O
# text=特殊 head=6 dep=acl ent_type= ent_job=O
...
# text=や head=12 dep=case ent_type= ent_job=O
# text=、 head=12 dep=punct ent_type= ent_job=O
# text=揚羽 head=18 dep=obl ent_type=PERSON ent_job=B
# text=と head=15 dep=case ent_type= ent_job=O
# text=薄羽 head=18 dep=compound ent_type=PERSON ent_job=B
# text=同様 head=24 dep=advcl ent_type= ent_job=O
# text=に head=18 dep=aux ent_type= ent_job=O
...
# text=くる head=26 dep=aux ent_type= ent_job=O
# text=。 head=26 dep=punct ent_type= ent_job=O
固有表現抽出ラベルが MISC 領域に他のデータと連結されて格納されていたので、ちょっと心配でしたが正しく解釈されています。 これなら大丈夫そうですね。
設定ファイルの準備
次は学習に使う設定ファイルを準備します。設定ファイルのひな形は https://spacy.io/usage/training#quickstart の UI で生成 することができます。以下のように選択すると設定ファイルのひな形が生成されるので、テキスト領域右下にあるボタンでコピーやダウンロードが可能です。8
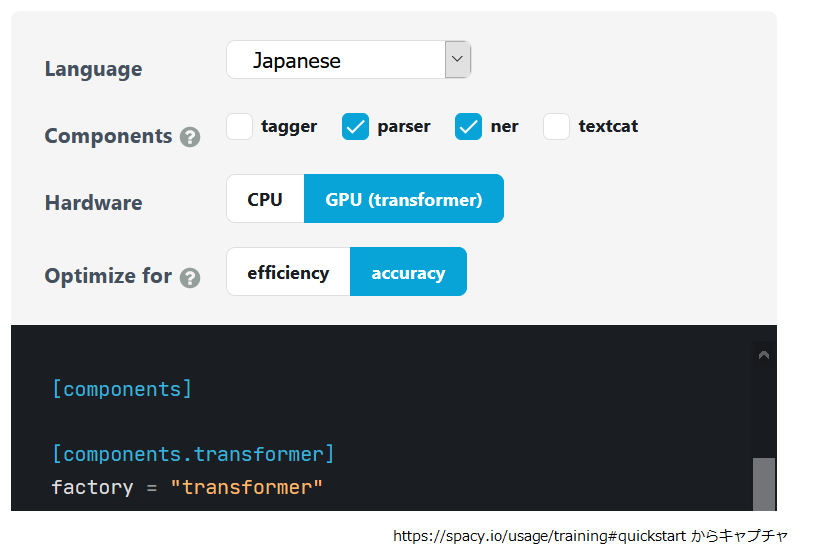
ですが、筆者が試した時点では Web の UI は多言語版の BERT を使う設定になってしまうので一部書き換えて以下のようにしています。
%%bash
cat << EOF > base_config.cfg
[paths]
train = null
dev = null

[system]
gpu_allocator = "pytorch"

[nlp]
lang = "ja"
pipeline = ["transformer","parser","ner", "attribute_ruler"]
batch_size = 128

[nlp.tokenizer]
@tokenizers = "spacy.ja.JapaneseTokenizer"
split_mode = "A"

[components]

[components.transformer]
factory = "transformer"

[components.transformer.model]
@architectures = "spacy-transformers.TransformerModel.v1"
name = "cl-tohoku/bert-base-japanese-whole-word-masking"
tokenizer_config = {"use_fast": false}


[components.transformer.model.get_spans]
@span_getters = "spacy-transformers.strided_spans.v1"
window = 128
stride = 96

[components.parser]
factory = "parser"

[components.parser.model]
@architectures = "spacy.TransitionBasedParser.v2"
state_type = "parser"
extra_state_tokens = false
hidden_width = 128
maxout_pieces = 3
use_upper = false
nO = null

[components.parser.model.tok2vec]
@architectures = "spacy-transformers.TransformerListener.v1"
grad_factor = 1.0

[components.parser.model.tok2vec.pooling]
@layers = "reduce_mean.v1"

[components.ner]
factory = "ner"

[components.ner.model]
@architectures = "spacy.TransitionBasedParser.v2"
state_type = "ner"
extra_state_tokens = false
hidden_width = 64
maxout_pieces = 2
use_upper = false
nO = null

[components.ner.model.tok2vec]
@architectures = "spacy-transformers.TransformerListener.v1"
grad_factor = 1.0

[components.ner.model.tok2vec.pooling]
@layers = "reduce_mean.v1"

[components.attribute_ruler]
factory = "attribute_ruler"
validate = false

[corpora]

[corpora.train]
@readers = "spacy.Corpus.v1"
path = \${paths.train}
max_length = 500

[corpora.dev]
@readers = "spacy.Corpus.v1"
path = \${paths.dev}
max_length = 0

[training]
accumulate_gradient = 3
dev_corpus = "corpora.dev"
train_corpus = "corpora.train"

[training.optimizer]
@optimizers = "Adam.v1"

[training.optimizer.learn_rate]
@schedules = "warmup_linear.v1"
warmup_steps = 250
total_steps = 20000
initial_rate = 5e-5

[training.batcher]
@batchers = "spacy.batch_by_padded.v1"
discard_oversize = true
size = 2000
buffer = 256

[initialize]
vectors = null
EOF
少し勢い余って(?)、パイプラインに attribute_ruler まで入れてしまいましたが、それを除けば Quickstart の生成内容との大きな違いは以下の二か所ですね。
[nlp.tokenizer]@tokenizers = "spacy.ja.JapaneseTokenizer"split_mode = "A"[components.transformer.model]@architectures = "spacy-transformers.TransformerModel.v1"name = "cl-tohoku/bert-base-japanese-whole-word-masking"tokenizer_config = {"use_fast": false}
一つ目は spaCy のトークナイザの設定で明示的に設定しておきました(これは不要かもしれません)。二つ目では Transformers で使用するモデルを "cl-tohoku/bert-base-japanese-whole-word-masking" に変更したうえで、 BertJapaneseTokenizer では Fast 実装がサポートされていなかった気がしたので、Fast 実装を使わない設定を追加してあります。
spaCy の設定ファイルは学習の再現性を確保する為、全ての設定項目を埋めるようになっています。ひな形を作ったら init fill-config で残りの項目をデフォルト値で埋めておきましょう。
!python -m spacy init fill-config base_config.cfg config.cfg
これで準備は完了です。それでは学習を動かしましょう。
学習の実行
学習の実行は train コマンドで行います。細かい設定は全て設定ファイルに記述されているので、後は出力先、学習データ、検証データのパス、使用する GPU の ID を渡すだけで OK です。
!python -m spacy train config.cfg --gpu-id 0 --output ./ja_ud_japanese_gsd_2.6_ne_trf \
  --paths.train ./corpus/ja_gsd-ud-train.ne.spacy --paths.dev ./corpus/ja_gsd-ud-dev.ne.spacy

# 2021-04-08 01:57:06.000442: I tensorflow/stream_executor/platform/default/dso_loader.cc:49] Successfully opened dynamic library libcudart.so.11.0
# ✔ Created output directory: ja_ud_japanese_gsd_2.6_ne_trf
# ℹ Using GPU: 0
#
# =========================== Initializing pipeline ===========================
# [2021-04-08 01:57:08,322] [INFO] Set up nlp object from config
# [2021-04-08 01:57:08,332] [INFO] Pipeline: ['transformer', 'parser', 'ner', 'attribute_ruler']
# [2021-04-08 01:57:08,336] [INFO] Created vocabulary
# [2021-04-08 01:57:08,336] [INFO] Finished initializing nlp object
# Downloading: 100% 479/479 [00:00<00:00, 568kB/s]
# Downloading: 100% 258k/258k [00:00<00:00, 1.01MB/s]
# Downloading: 100% 445M/445M [00:09<00:00, 47.1MB/s]
# [2021-04-08 01:59:29,659] [INFO] Initialized pipeline components: ['transformer', 'parser', 'ner', 'attribute_ruler']
# ✔ Initialized pipeline
#
# ============================= Training pipeline =============================
# ℹ Pipeline: ['transformer', 'parser', 'ner', 'attribute_ruler']
# ℹ Initial learn rate: 0.0
# E    #       LOSS TRANS...  LOSS PARSER  LOSS NER  DEP_UAS  DEP_LAS  SENTS_F  ENTS_F  ENTS_P  ENTS_R  SCORE
# ---  ------  -------------  -----------  --------  -------  -------  -------  ------  ------  ------  ------
#   0       0        1081.68       242.29    135.19     8.59     2.35     0.03    0.09    0.05    0.38    0.03
#   1     200      428225.47    305469.59  78684.85    81.83    70.61    51.50    0.00    0.00    0.00    0.38
#   3     400      135577.50     69966.58  23143.13    91.19    88.17    96.95   50.11   57.86   44.19    0.70
#   4     600       88221.54     36785.87  15648.66    92.62    90.33    99.40   61.05   65.26   57.34    0.76
#   6     800       60844.47     26837.50  10269.43    93.02    91.29    99.40   73.07   74.27   71.90    0.83
#   7    1000       43104.91     19039.09   6712.55    93.35    91.68    99.90   75.48   75.87   75.10    0.84
#   9    1200       33407.07     14050.53   4485.42    93.59    91.92    98.90   77.26   76.63   77.91    0.85
#  10    1400       25040.19     10510.83   3046.26    93.74    92.09    99.00   78.12   78.73   77.52    0.86
#  12    1600       23352.28      7855.36   2304.21    93.46    91.87    99.20   80.51   80.30   80.72    0.87
#  13    1800       16616.46      6212.21   1732.93    93.56    91.94    98.70   80.64   80.95   80.33    0.87
#  15    2000       13145.35      4595.16   1308.99    93.69    92.17    99.80   82.29   81.82   82.76    0.88
#  17    2200       11520.45      3944.25   1001.26    93.81    92.17    98.80   81.63   81.27   81.99    0.87
#  18    2400       10425.42      3245.94    890.20    93.82    92.16    99.50   80.99   80.38   81.61    0.87
#  20    2600        8757.12      2775.12    717.07    93.95    92.49    99.90   81.42   80.60   82.25    0.87
#  21    2800        7638.03      2284.72    635.12    93.87    92.38    99.50   81.31   81.78   80.84    0.87
#  23    3000        7650.16      2055.74    656.33    93.82    92.30    99.30   82.39   82.92   81.86    0.88
#  24    3200        6092.75      1674.14    570.70    93.85    92.43    99.30   83.40   83.40   83.40    0.88
#  26    3400        6273.59      1600.29    525.07    94.03    92.51    99.50   82.27   82.17   82.38    0.88
#  27    3600        6342.30      1334.66    548.55    93.73    92.38    99.10   83.29   83.18   83.40    0.88
#  29    3800        5773.50      1317.69    518.69    93.75    92.31    99.60   82.37   82.11   82.63    0.88
#  31    4000        6873.94      1081.85    517.94    93.57    92.08    99.50   81.02   81.07   80.97    0.87
#  32    4200        4384.41       951.09    474.45    93.88    92.36    99.20   80.49   80.64   80.33    0.87
#  34    4400        4984.87       924.53    465.41    93.88    92.48    99.50   81.44   80.78   82.12    0.87
#  35    4600        5375.62       789.03    510.97    93.77    92.28    99.90   81.31   82.05   80.59    0.87
#  37    4800        3915.39       684.97    458.90    93.60    92.02    99.60   81.54   81.85   81.23    0.87
# ✔ Saved pipeline to output directory
# ja_ud_japanese_gsd_2.6_ne_trf/model-last
学習中に表示されるメトリクスは https://spacy.io/usage/training#metrics の “Understanding the training output and score types” に説明があります。 P, R, F はそれぞれ Precision, Recall, F1-score です。この連載で扱ったことがないのは係り受け解析の UAS と LAS でしょうか。 UAS は依存関係の指し先がどれだけ正しいかの割合です。LAS は依存関係の指し先に加えてそのラベルの正誤も考慮したものです。
学習後、出力先ディレクトリには最良値のモデルと最終のモデルが格納されています。
!ls ja_ud_japanese_gsd_2.6_ne_trf/
# model-best  model-last
テストデータでの評価
evaluate コマンドでモデルの評価を実行します。--displacy-path を付けておくと推論結果をビジュアライズした HTML を出力してくれます。
!mkdir -p ./evaluate_result
!python -m spacy evaluate ./ja_ud_japanese_gsd_2.6_ne_trf/model-best ./corpus/ja_gsd-ud-test.ne.spacy -\
  -output ./test_metrics.json --gpu-id 0 --displacy-path ./evaluate_result
# 2021-04-08 04:13:25.297983: I tensorflow/stream_executor/platform/default/dso_loader.cc:49] Successfully opened dynamic library libcudart.so.11.0
# ℹ Using GPU: 0
#
# ================================== Results ==================================
#
# TOK      99.75
# UAS      92.91
# LAS      90.94
# NER P    82.65
# NER R    82.92
# NER F    82.79
# SENT P   98.72
# SENT R   99.45
# SENT F   99.08
# SPEED    1903
#
#
# =============================== LAS (per type) ===============================
#
#                  P       R       F
# obl          82.33   85.02   83.65
# case         97.92   97.46   97.69
# compound     94.86   89.44   92.07
# obj          96.19   94.80   95.49
# acl          88.50   87.14   87.81
# nsubj        81.24   81.99   81.61
# advcl        75.97   76.35   76.16
# aux          95.64   95.76   95.70
# mark         94.64   93.73   94.18
# advmod       80.67   63.02   70.76
# nmod         90.30   87.67   88.96
# root         95.76   95.76   95.76
# fixed        94.42   97.89   96.12
# ccomp        85.37   92.11   88.61
# cop          93.18   92.13   92.66
# cc           79.07   80.95   80.00
# det          94.12   96.97   95.52
# nummod       94.09   85.89   89.80
# amod         96.43   61.36   75.00
# csubj        85.71   85.71   85.71
# dep           0.00    0.00    0.00
# dislocated   80.00   44.44   57.14
# discourse     0.00    0.00    0.00
#
#
# =============================== NER (per type) ===============================
#
#                    P        R        F
# NORP           76.92    71.43    74.07
# ORG            67.50    72.00    69.68
# PERSON         87.78    88.76    88.27
# DATE           93.67    88.10    90.80
# PERCENT        87.50   100.00    93.33
# GPE            87.65    86.59    87.12
# TITLE_AFFIX    94.44    85.00    89.47
# WORK_OF_ART    78.95    83.33    81.08
# QUANTITY       91.36    94.87    93.08
# EVENT          90.00    64.29    75.00
# FAC            56.25    45.00    50.00
# MONEY          55.56    71.43    62.50
# PRODUCT        58.33    60.87    59.57
# TIME           80.00    92.31    85.71
# LOC            88.00    88.00    88.00
# LANGUAGE      100.00   100.00   100.00
# ORDINAL        86.67   100.00    92.86
# MOVEMENT       28.57    50.00    36.36
# LAW           100.00    66.67    80.00
#
# /usr/local/lib/python3.7/dist-packages/spacy/displacy/__init__.py:189: UserWarning: [W006] No entities to visualize found in Doc object. If this is surprising to you, make sure the Doc was processed using a model that supports named entity recognition, and check the `doc.ents` property manually if necessary.
#   warnings.warn(Warnings.W006)
# ✔ Generated 25 parses as HTML
# evaluate_result
# ✔ Saved results to test_metrics.json
指定したディレクトリに HTML が出力されています。
!ls  evaluate_result
# entities.html  parses.html
IPython.display.HTML をインポートして表示してみましょう。
from IPython.display import HTML
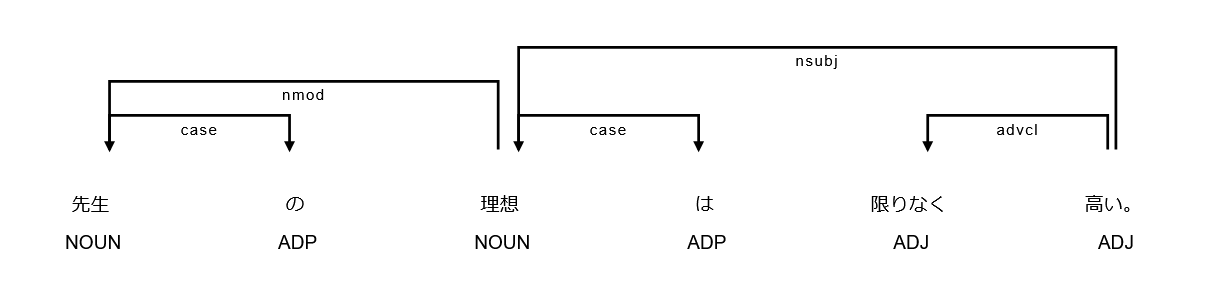
まずは係り受け解析です(処理結果は一部だけ画像で示します)。
HTML("evaluate_result/parses.html")
次に固有表現抽出です(処理結果は一部だけ画像で示します)
HTML("evaluate_result/entities.html")

最後に transformer を tok2vec に差し替えたモデルと性能を比べてみましょう。
tok2vec のモデルは https://spacy.io/usage/training#quickstart を利用し
- Japanese
parser,ner- CPU
- accuracy
で設定を生成しました。後の手順は同じです。
まずは係り受け解析での性能比較です。2pt 前後ですが transformer の方が良い結果になっています。
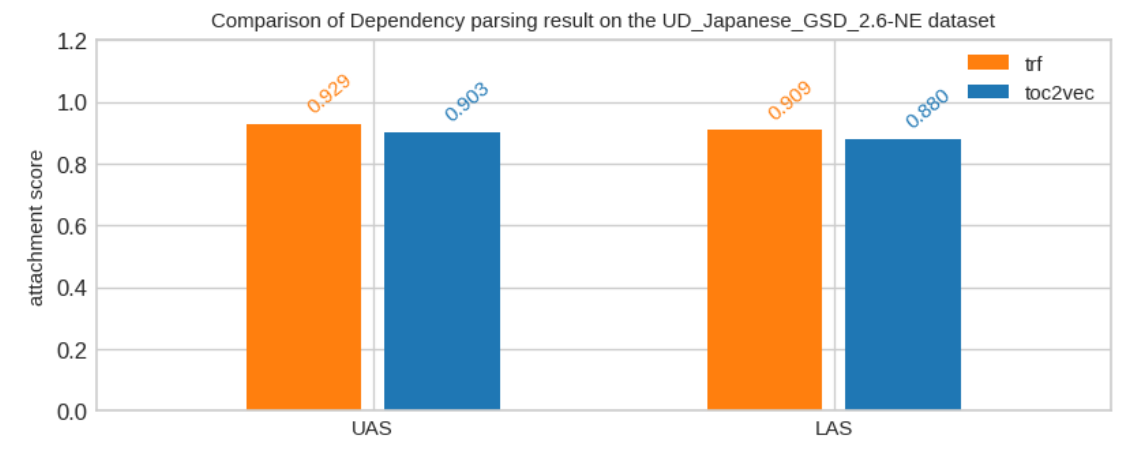
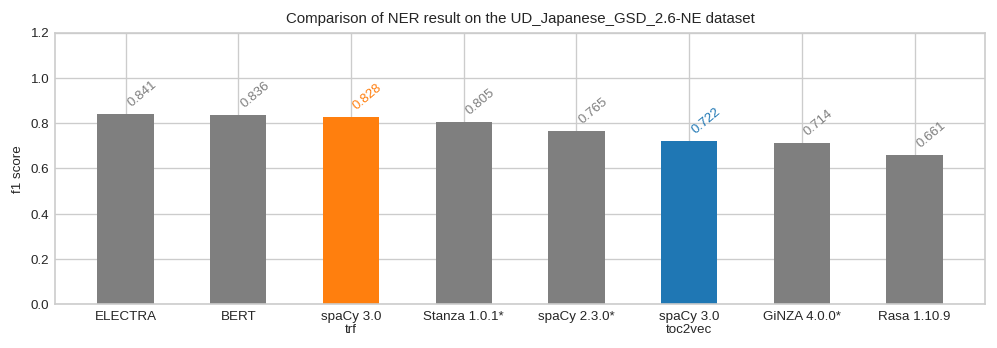
次に固有表現抽出です。グレーのバーは第12回からの転記です。こちらは transformer と toc2vec でかなり差がつきましたね。ですが、ELECTRA, と BERT には及びませんでした。この BERT のスコアは同じ事前学習済みモデルを用いているのですが、マルチタスク学習を行っている分 spaCy が不利だったかもしれませんね。ですが、推論で利用する時の手軽さを考えると spaCy でいいやって気分ですね。
あと、学習済みパイプラインの使い方も少しだけ補足しておきますね。
学習済みパイプラインのロードとパッケージング
学習済みのパイプラインは次のようにしてロードできます。
import spacy
nlp = spacy.load("./ja_ud_japanese_gsd_2.6_ne_trf/model-best")
nlp.pipeline
# [('transformer',
#  <spacy_transformers.pipeline_component.Transformer at 0x7f52f32b5b90>),
# ('parser', <spacy.pipeline.dep_parser.DependencyParser at 0x7f52f32a5c20>),
# ('ner', <spacy.pipeline.ner.EntityRecognizer at 0x7f52f3209280>),
# ('attribute_ruler',
#  <spacy.pipeline.attributeruler.AttributeRuler at 0x7f52f31bfbe0>)]
学習済みパイプラインをパッケージにまとめられるようになったので、 pip でインストールすることもできます。
!mkdir -p ./package
!python -m spacy package ./ja_ud_japanese_gsd_2.6_ne_trf/model-best ./package --name udjagsd26ne_trf --version 0.0.1
# 2021-04-09 07:11:37.549268: I tensorflow/stream_executor/platform/default/dso_loader.cc:49] Successfully opened dynamic library libcudart.so.11.0
# ℹ Building package artifacts: sdist
# ✔ Loaded meta.json from file
# ja_ud_japanese_gsd_2.6_ne_trf/model-best/meta.json
# ✔ Successfully created package 'ja_udjagsd26ne_trf-0.0.1
# ...
# Creating tar archive
# removing 'ja_udjagsd26ne_trf-0.0.1' (and everything under it)
# ✔ Successfully created zipped Python package
# package/ja_udjagsd26ne_trf-0.0.1/dist/ja_udjagsd26ne_trf-0.0.1.tar.gz

!pip install ./package/ja_udjagsd26ne_trf-0.0.1

!pip list | grep udjagsd26ne
# ja-udjagsd26ne-trf            0.0.1

import spacy
nlp = spacy.load("ja_udjagsd26ne_trf")
nlp.pipeline
# [('transformer',
#  <spacy_transformers.pipeline_component.Transformer at 0x7f52f32b5b90>),
# ('parser', <spacy.pipeline.dep_parser.DependencyParser at 0x7f52f32a5c20>),
# ('ner', <spacy.pipeline.ner.EntityRecognizer at 0x7f52f3209280>),
# ('attribute_ruler',
#  <spacy.pipeline.attributeruler.AttributeRuler at 0x7f52f31bfbe0>)]
実際に処理をしてみましょう。文章は CC-100 コーパス( http://data.statmt.org/cc-100/ja.txt.xz )から適当に抜粋したものです。
doc = nlp("""
闇金業者に借金をしてしまうと、元金の返済はおろか、借金が増えていく一方で、心苦しい思いをしてしまうものです。
そして、そのような状態になってしまうと、知りつつ借金したから誰にも頼れない心情となり、一人で悩みを抱え込み、解決策に気づけなくなってしまうことも多々あるのです。
そのような際の解決方法を見つけたいなら、まず他人に相談するのが大切ではないでしょうか。
一人で悩みを抱え込むと、周りが見えなくなってしまい、余計につらくなってしまうことがあります。
そして、そのような時には弁護士や司法書士に相談するのが最良の対処法といえ、無料の相談サービスを利用して悩みを聞いてもらうのがよいのではないでしょうか。
こういった法務事務所・法律事務所ではいつも、ヤミ金問題に困っている人たちの相談に乗っていて、弁護士や司法書士からの助言がもらえるので、とても役立ちます。
ヤミ金解決に数多くの実績がある、人情派弁護士に、あなたの悩み・苦しみを、まずは無料相談してみては?
北海道から沖縄まで、全国対応の事務所だから、東温市に住んでいる方ももちろん相談OKです。
解決に伴う手数料も、分割払いOKなので、今は支払うお金が無くても、安心して相談できます。
ヤミ金に悩んでいる東温市の女性の方、今スグここで無料相談してみませんか?
地元の東温市の近くの法務事務所・法律事務所は下記を参考にどうぞ。
一般の司法書士・弁護士事務所は、通常の債務整理についての相談は受け付けているのですが、闇金の問題に関しては、相談を受け付けていないケースも多くあります。
東温市近辺の弁護士事務所や司法書士事務所でも、そういうところが多いかもしれません。
闇金業者から借金をしてしまった結果、最初こそ普通の督促の電話があったものの後半には脅迫染みた電話がかかってきたり、家に怒鳴り込まれたりするなどあくどい債権回収を行われる場合があります。
このような状況になってしまったら、弁護士や司法書士等に相談することが一番ですが、借金をしていることへの負い目や、闇金業者からの仕返しを恐れて相談や通報をためらってしまう場合もあるようです。
また、弁護士や司法書士に依頼するのに歯止めをかけてしまう理由に、報酬を支払う余裕がない、という場合もあります。
法律関連に強いのが彼らですから、闇金業者が如何に不法かを分かりやすく説明し、現在の目も当てられない状況を解決する手伝いしてくれます。
弁護士や司法書士への依頼費用が高いと悩んでいる方も、無料で相談を受け付けている司法書士事務所や弁護士事務所もあります。
ヤミ金業者からお金を借りてしまうと、元金の返済どころか、借金が増えていくばかりで、ドツボにはまっていってしまうものです。
しかも、闇金にお金を借りるという状況は、ずいぶんお金に追い詰められた状況だけに、そのような人が、ヤミ金業者から借金をして返済できるわけがありません。
そして、そのような状態になってしまうと、知りつつ借りたから人に頼れない心情になり、1人だけで悩みを抱え込んで、打開方法に気づけなくなってしまうこともあります。
そのような時の対策というのは、まず人に相談することが一番です。
""")
固有表現抽出の結果です。
for ent in doc.ents:
    print(ent.text, ent.start_char, ent.end_char, ent.label_)
# 一人 99 101 QUANTITY
# 一人 181 183 QUANTITY
# 北海道 431 434 GPE
# 沖縄 436 438 LOC
# 東温市 453 456 GPE
# 東温市 530 533 GPE
# 東温市 561 564 GPE
# 東温市 668 671 GPE
# 一番 837 839 ORDINAL
# 司法書士事務 1060 1066 ORG
# 1人 1258 1260 QUANTITY
手軽に使えるのが嬉しいですね。ちなみに Transformers の処理結果は doc._.trf_data に格納されています。
type(doc._.trf_data)
# spacy_transformers.data_classes.TransformerData
データ型は TransformerData で、これは transformer コンポーネントが返す FullTransformerBatch から Doc 一つ分を切り出したものになります。
幾つか属性を見ていきましょう。
doc._.trf_data.tokens
doc._.trf_data.tokens は Dict になっていて馴染みのある情報が格納されています。
doc._.trf_data.tokens.keys()
# dict_keys(['input_ids', 'attention_mask', 'input_texts', 'token_type_ids'])

doc._.trf_data.tokens["input_ids"].shape
# torch.Size([9, 136])
どうやら長さ 136 の 9 つの Span が生成されたようです。tokens["input_ids"] の中身はこんな感じですね。
doc._.trf_data.tokens["input_ids"]
# tensor([[    2,  8517,   412,  ...,     3,     0,     0],
#         [    2,   737,     6,  ...,     0,     0,     0],
#         [    2,    10, 10963,  ...,     0,     0,     0],
#        ...,
#         [    2,   395, 28887,  ...,     0,     0,     0],
#         [    2,    33,  5454,  ...,     0,     0,     0],
#         [    2,     8,   893,  ...,     0,     0,     0]])
tokens["input_texts"] はサブワード分割されたトークン文字列のリストです。
len(doc._.trf_data.tokens["input_texts"])
# 9

doc._.trf_data.tokens["input_texts"][0][:10]
# ['[CLS]', '闇', '金', '業者', 'に', '借金', 'を', 'し', 'て', 'しまう']

doc._.trf_data.tokens["input_texts"][1][:10]
# ['[CLS]', 'なら', '、', 'まず', '他人', 'に', '相談', 'する', 'の', 'が']
doc._.trf_data.tensors
doc._.trf_data.tensors は Transformers の最終層の出力全体と"[CLS]"に対応する出力です。
len(doc._.trf_data.tensors)
# 2

doc._.trf_data.tensors[0].shape
# (9, 136, 768)

doc._.trf_data.tensors[1].shape
# (9, 768)
doc._.trf_data.align
doc._.trf_data.align はアライメント情報を格納した Ragged になります。
ここでは data に全 Span のサブワードをフラットに並べた時のインデックスが格納されているようです。
こまかくチェックはしてないのですが、 lengths で 2 が並んでいるところは Span の重なり部分、単発で 2 や 3 や 4 が出ているところは単語が複数のサブワードに分割されたところでしょう。 0 はなんでしょう。。。特殊トークンの類かな? ちゃんと調べてないので、ちょっとわかりません。。
doc._.trf_data.align
# Ragged(data=array([[   1],
#        [   2],
#        [   3],
#        ...,
#        [1157],
#        [1158],
#        [1159]], dtype=int32), lengths=array([0, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1,
#        1, 1, 1, 1, 3, 1, 1, 1, 1, 1, 1, 1, 1, 0, 1, 1, 1, 1, 1, 1, 1, 1,
#        1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 1, 1, 1, 1, 1, 2, 1, 1,
#        1, 1, 1, 1, 1, 1, 1, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 1, 1,
#        1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 4,
#        ...
#        1, 1, 1, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
#        1, 1, 1, 0], dtype=int32), data_shape=(-1,), cumsums=None)
doc._.trf_data.width
doc._.trf_data.width は Transformers の特徴量の次元数ですね。
doc._.trf_data.width
# 768
さて、ここまでは順調というかイージーモードであっという間に一回分の記事が書きあがる感じでした。。。
4. PyTorch を用いたカスタムモデルの利用
PyTorch を用いたカスタムモデルの話をする前に、事の経緯の説明から。
ちょっと長めの経緯というか。。。
前章までがいい感じだったので、調子にのって文章分類もやってみようと思ったわけです。まず、spaCy 3.0 で文章分類する場合、使えるモデルのアーキテクチャは複数あります。
- spacy.TextCatBOW.v1 : Bag of Words を使った一番シンプルなモデルです。
- spacy.TextCatCNN.v1 :
Token単位に特徴量を抽出し CNN に通します。
特徴量抽出の方法にはtok2vecとtransformerがあります。- spacy-transformers.TransformerModel.v1
- spacy.Tok2Vec.v2
- spacy.TextCatEnsemble.v2 : BOW と CNN のアンサンブルです。
こちらも CNN の特徴量抽出が2種類あります。- spacy-transformers.TransformerModel.v1
- spacy.Tok2Vec.v2
データセットとしてはこの連載で何回か使った livedoor News Corpus を使ってやってみた訳ですが非常に苦戦しました。 まともに動いたのが、 spacy.TextCatBOW.v1 のみで F1(macro) で 91.93 でした。。。
Transformers に絡めた話を書きたい訳なのですが、「うまく動きませんでした」では恰好が付きませんし、内容に間違いがありそうです。 どうしようかと悩んだ末に、もう少しシンプルなデータで試そうということになり、第2回で使用した Natural Language Understanding benchmark データセットを手作業で日本語化したデータを使いました。学習データは300件づつの7分類で合計2100件です(詳しくは第2回を参照してください)。
データを変えたら楽勝だったかというと、全然そうではありませんでした。。。。
データの準備
データは公開してないので Python の変数にロードしたところから話を始めます。
examples_train = load_data("nlu_bench_train.json")
examples_dev = load_data("nlu_bench_validate.json")
雰囲気はこんな感じです。
examples_train[:5]
# [('SearchCreativeWork', '過保護のカホコを見つけるの手伝ってくれる。'),
#  ('SearchCreativeWork', 'REX 恐竜物語!の予告編を見つけてくれない。'),
#  ('RateBook', '今のエッセイは6スターで1です。'),
#  ('SearchScreeningEvent', 'どこでシャッター アイランドはやってますか。'),
#  ('RateBook', '秘密の花園に4スターあげて。')]
データ形式を変換します。
import spacy
from spacy.tokens import DocBin
nlp = spacy.blank("ja")

def convert(examples, filename_docbin):
  labels = []
  texts = []
  for label, text in examples:
    labels.append(label)
    texts.append(text)
  docs = list(nlp.pipe(texts))
  print("convert {} docs to DocBin(*.spacy) file.".format(len(docs)))
  for label, doc in zip(labels, docs):
    doc.cats[label] = 1.0
  doc_bin = DocBin(docs=docs)
  doc_bin.to_disk(filename_docbin)

convert(examples_train, "./train.spacy")
convert(examples_dev, "./dev.spacy")
念のため、ラベルの種類と数を確認します。
import spacy
from spacy.tokens import Doc, DocBin

def count_label(filename):
  nlp = spacy.blank("ja")
  train_data = DocBin()
  train_data.from_disk(path=filename)
  docs = list(train_data.get_docs(nlp.vocab))
  count = {}
  num_docs = 0
  for i, doc in enumerate(docs):
    for key in doc.cats.keys():
      if key not in count:
        count[key] = doc.cats[key]
      else:
        count[key] += doc.cats[key]
    num_docs += 1
  return num_docs, count
学習データの件数を確認します。
count_label("./train.spacy")
# (2100,
# {'AddToPlaylist': 300.0,
#  'BookRestaurant': 300.0,
#  'GetWeather': 300.0,
#  'PlayMusic': 300.0,
#  'RateBook': 300.0,
#  'SearchCreativeWork': 300.0,
#  'SearchScreeningEvent': 300.0})
2100件あります。検証データも見てみましょう。
count_label("./dev.spacy")
# (700,
#  {'AddToPlaylist': 100.0,
#  'BookRestaurant': 100.0,
#  'GetWeather': 100.0,
#  'PlayMusic': 100.0,
#  'RateBook': 100.0,
#  'SearchCreativeWork': 100.0,
#  'SearchScreeningEvent': 100.0})
こちらは 100 件づつ、の合計 700 件です。ここから実際に文章分類をしていきます。
spacy.TextCatBOW.v1
まずは spacy.TextCatBOW.v1 で試してみます。
!python -m spacy init config base_bow_config.cfg --lang ja --pipeline textcat --optimize efficiency --force
!python -m spacy init fill-config base_bow_config.cfg bow_config.cfg
!python -m spacy train bow_config.cfg --output ./ja_textcat_bow --paths.train ./train.spacy --paths.dev ./dev.spacy
!python -m spacy evaluate ./ja_textcat_bow/model-best ./dev.spacy --output ./metrics_ja_textcat_bow.json
# ...
# ================================== Results ==================================
#
# TOK                 100.00
# TEXTCAT (macro F)   99.06
# SPEED               341728
# ...
F1(macro) で 99.06 です。楽勝のデータですね。次に transformer を使ったアンサンブルを試してみました。
spacy.TextCatEnsemble.v2 (tok2vec=spacy-transformers.TransformerModel.v1)
設定ファイルのひな形はこんな感じです。
%%bash
cat << EOF > base_ensemble_config.cfg
[paths]
train = null
dev = null

[system]
gpu_allocator = "pytorch"

[nlp]
lang = "ja"
pipeline = ["transformer", "textcat"]
batch_size = 64

[nlp.tokenizer]
@tokenizers = "spacy.ja.JapaneseTokenizer"
split_mode = "A"

[components]

[components.transformer]
factory = "transformer"

[components.transformer.model]
@architectures = "spacy-transformers.TransformerModel.v1"
name = "cl-tohoku/bert-base-japanese-whole-word-masking"
tokenizer_config = {"use_fast": false}


[components.transformer.model.get_spans]
@span_getters = "spacy-transformers.strided_spans.v1"
window = 512
stride = 384

[components.textcat]
factory = "textcat"

[components.textcat.model]
@architectures = "spacy.TextCatEnsemble.v2"
nO = null

[components.textcat.model.tok2vec]
@architectures = "spacy-transformers.TransformerListener.v1"
grad_factor = 1.0

[components.textcat.model.tok2vec.pooling]
@layers = "reduce_mean.v1"

[components.textcat.model.linear_model]
@architectures = "spacy.TextCatBOW.v1"
exclusive_classes = true
ngram_size = 1
no_output_layer = false

[corpora]

[corpora.train]
@readers = "spacy.Corpus.v1"
path = \${paths.train}
max_length = 0

[corpora.dev]
@readers = "spacy.Corpus.v1"
path = \${paths.dev}
max_length = 0

[training]
accumulate_gradient = 3
dev_corpus = "corpora.dev"
train_corpus = "corpora.train"

[training.optimizer]
@optimizers = "Adam.v1"

[training.optimizer.learn_rate]
@schedules = "warmup_linear.v1"
warmup_steps = 250
total_steps = 20000
initial_rate = 5e-5

[training.batcher]
@batchers = "spacy.batch_by_padded.v1"
discard_oversize = true
size = 2000
buffer = 256

[initialize]
vectors = null
EOF
デフォルト値を埋めて、学習と評価を動かします。
!python -m spacy init fill-config base_ensemble_config.cfg ensemble_config.cfg
!python -m spacy train ensemble_config.cfg --gpu-id 0 --output ./ja_textcat_trf_ensemble --paths.train ./train.spacy --paths.dev ./dev.spacy
!python -m spacy evaluate ./ja_textcat_trf_ensemble/model-best ./dev.spacy --output ./test_metrics_ja_textcat_trf_ensemble.json --gpu-id 0
# ...
# ================================== Results ==================================
#
# TOK                 100.00
# TEXTCAT (macro F)   0.00
# SPEED               4470
# ...
何がダメなんでしょう。ハイパーパラメータ云々はあまり考えていないですが、まともに動きさえすればスコアはそれなりに出ると思うのです。ランダムでも 1/7 の確率で当たる訳で。。。ひょっとして Transformers との連携部分に問題あるかと思い Tok2Vec を試してみました。
spacy.TextCatEnsemble.v2 (tok2vec=spacy.Tok2Vec.v2)
もう私が設定ファイルのひな形を記述するところも疑わしく感じられたので、spaCy のコマンドを動かすだけにしておきます。
!python -m spacy init config base_toc2vec_ensemble_config.cfg --lang ja --pipeline textcat --optimize accuracy
!python -m spacy init fill-config base_toc2vec_ensemble_config.cfg toc2vec_ensemble_config.cfg
生成された設定ファイルでは公開されている日本語モデルの単語ベクトルを使うのでダウンロードしておきます。
!python -m spacy download ja_core_news_lg
それでは学習して、評価します9。
!python -m spacy train toc2vec_ensemble_config.cfg --gpu-id 0 --output ./ja_textcat_t2v_ensemble --paths.train ./train.spacy --paths.dev ./dev.spacy
!python -m spacy evaluate ./ja_textcat_t2v_ensemble/model-best ./dev.spacy --output ./test_metrics_ja_textcat_t2v_ensemble.json --gpu-id 0
# ...
# ================================== Results ==================================
# TOK                 100.00
# TEXTCAT (macro F)   18.75
# SPEED 15999
# ...
F1(macro) で 18.75 です。 ランダム(1/7=0.143) よりはマシなスコアが出ましたね。 transformer を使うからダメという話ではなさそうです。
一番単純な BOW ではスコアが出ているので、データの作り方とかオプティマイザとかで致命的な問題を抱えている訳でもなさそうです。
どうしたものかと思案していたら、 spaCy 3.0 では PyTorch ベースのカスタムモデルをパイプラインに組み込めることが出来るのを思い出したので、spacy.TextCat* はガッサリ捨てて、 Transformers を PyTorch のカスタムモデルとして組み込むことにしました。
PyTorch ベースのカスタムモデル
さて、ようやくこの章の本題にもどってきました。
spaCy で PyTorch ベースのカスタムモデルを組み込む際は PyTorch のモデルを入出力の変換関数と一緒に PyTorchWapper でくるむだけで OK です。
記述が必要なコードは以下のようになります。
%%bash
cat << EOF > wrap_trf.py
import torch
import spacy
from spacy.tokens import Doc
from typing import List, Tuple, Callable
from thinc.types import Floats2d
from thinc.api import Model, chain, softmax_activation
from thinc.api import PyTorchWrapper
from thinc.api import ArgsKwargs, torch2xp, xp2torch
from transformers.tokenization_utils_base import BatchEncoding
from transformers import BertJapaneseTokenizer, BertForSequenceClassification

def extract_bert_inputs(name) -> Model[List[Doc], BatchEncoding]: # ②
  def forward_bert_inputs(model: Model, docs: List[Doc], is_train: bool):
    tokenizer = model.attrs["tokenizer"]
    texts = [str(doc) for doc in docs]
    bert_inputs = tokenizer(texts, padding=True, truncation=True, return_tensors="pt")
    def backprop(dY):
      return []
    return bert_inputs, backprop
  tokenizer = BertJapaneseTokenizer.from_pretrained(name)
  model = Model("extract_bert_input",
                forward_bert_inputs,
                attrs={"tokenizer": tokenizer})
  return model

def convert_transformer_inputs(model, bert_inputs: BatchEncoding, is_train): # ③
    kwargs = {
        "input_ids": bert_inputs.input_ids,
        "attention_mask": bert_inputs.attention_mask,
        "token_type_ids": bert_inputs.token_type_ids,
    }
    return ArgsKwargs(args=(), kwargs=kwargs), lambda dX: []

def convert_transformer_outputs( # ④
    model: Model,
    inputs_outputs: Tuple[BatchEncoding, Tuple[torch.Tensor]],
    is_train: bool
) -> Tuple[Floats2d, Callable]:
    bert_inputs, trf_outputs = inputs_outputs
    logits = torch2xp(trf_outputs[0])
    def backprop(d_logits: Floats2d) -> ArgsKwargs:
        return ArgsKwargs(
            args=(trf_outputs[0],),
            kwargs={"grad_tensors": xp2torch(d_logits)},
        )
    return logits, backprop

@spacy.registry.architectures("TextCatTrfSeqClassify.v1")
def build_trf_cls_token(
  name,
  num_labels
) -> Model[List[Doc], Floats2d]: # ①
    bert_inputs = extract_bert_inputs(name)
    bert = BertForSequenceClassification.from_pretrained(name, num_labels=num_labels)
    wrapped = PyTorchWrapper(bert, convert_inputs=convert_transformer_inputs,
            convert_outputs=convert_transformer_outputs)
    model = chain(bert_inputs, wrapped, softmax_activation()) # ⑤
    model.attrs["multi_label"] = False
    return model
EOF
簡単に補足説明を入れておきます。
- ① 大枠として
Docのリストを受け取って、[Doc数, クラス数 ] の浮動小数点行列にして返すモデルになります。 - ② モデルの先頭は
DocのリストをBatchEncoding(Transformers のトークナイザの処理結果のクラス)に変換する処理です。 - ③ 入力側の変換は
BertForSequenceClassificationのキーワード引数に合わせてBatchEncodingから属性を取り出す処理です。 - ④ 出力側の変換は forward側は PyTorch のテンソルを Thinc の xp (numpy or cupu) に変換、backword側でその逆を行う処理です10。
inputs_outputsはBertForSequenceClassificationの入力と出力です。出力側のtrf_outputs[0]は softmax 前の logits ですね。 - ⑤ BertForSequenceClassification で算出した logits を softmax して確信度にしています。
カスタムコードを書いたときは spaCy がコードを見つけられるように –code オプションを付けるのですが init fill-config コマンドには –code オプションがないようなので、設定ファイル全体を記述しました。
%%bash
cat << EOF > wrap_trf.cfg
[paths]
train = null
dev = null
vectors = null
init_tok2vec = null

[system]
gpu_allocator = "pytorch"
seed = 0

[nlp]
lang = "ja"
pipeline = ["textcat"]
batch_size = 16
disabled = []
before_creation = null
after_creation = null
after_pipeline_creation = null

[nlp.tokenizer]
@tokenizers = "spacy.ja.JapaneseTokenizer"
split_mode = "A"

[components]

[components.textcat]
factory = "textcat"
threshold = 0.0

[components.textcat.model]
@architectures = "TextCatTrfSeqClassify.v1"
name = "cl-tohoku/bert-base-japanese-whole-word-masking"
num_labels = 7

[corpora]

[corpora.dev]
@readers = "spacy.Corpus.v1"
path = \${paths.dev}
max_length = 0
gold_preproc = false
limit = 0
augmenter = null

[corpora.train]
@readers = "spacy.Corpus.v1"
path = \${paths.train}
max_length = 500
gold_preproc = false
limit = 0
augmenter = null

[training]
accumulate_gradient = 3
dev_corpus = "corpora.dev"
train_corpus = "corpora.train"
seed = \${system.seed}
gpu_allocator = \${system.gpu_allocator}
dropout = 0.1
patience = 1600
max_epochs = 0
max_steps = 20000
eval_frequency = 200
frozen_components = []
before_to_disk = null

[training.batcher]
@batchers = "spacy.batch_by_padded.v1"
discard_oversize = true
size = 2000
buffer = 256
get_length = null

[training.logger]
@loggers = "spacy.ConsoleLogger.v1"
progress_bar = false

[training.optimizer]
@optimizers = "Adam.v1"
beta1 = 0.9
beta2 = 0.999
L2_is_weight_decay = true
L2 = 0.01
grad_clip = 1.0
use_averages = false
eps = 0.00000001

[training.optimizer.learn_rate]
@schedules = "warmup_linear.v1"
warmup_steps = 250
total_steps = 20000
initial_rate = 0.0001

[training.score_weights]
cats_score_desc = null
cats_micro_p = null
cats_micro_r = null
cats_micro_f = null
cats_macro_p = null
cats_macro_r = null
cats_macro_f = null
cats_macro_auc = null
cats_f_per_type = null
cats_macro_auc_per_type = null
cats_score = 1.0

[pretraining]

[initialize]
vectors = null
init_tok2vec = \${paths.init_tok2vec}
vocab_data = null
lookups = null
before_init = null
after_init = null

[initialize.components]

[initialize.tokenizer]
EOF
学習を実行します。 –code オプションを付けてカスタムコードを見つけられるようにする必要があります。
!python -m spacy train wrap_trf.cfg --gpu-id 0 --output ./ja_textcat_wrap_trf \
  --paths.train ./train.spacy --paths.dev ./dev.spacy \
  --code wrap_trf.py
# 2021-05-03 04:43:10.522425: I tensorflow/stream_executor/platform/default/dso_loader.cc:49] Successfully opened dynamic library libcudart.so.11.0
# ✔ Created output directory: ja_textcat_wrap_trf
# ℹ Using GPU: 0
# ...
# ============================= Training pipeline =============================
# ℹ Pipeline: ['textcat']
# ℹ Initial learn rate: 0.0
# E    #       LOSS TEXTCAT  CATS_SCORE  SCORE
# ---  ------  ------------  ----------  ------
#   0       0          0.73       13.62    0.14
#   8     200         14.88       97.53    0.98
#  16     400          0.02       98.99    0.99
#  24     600          0.00       98.99    0.99
#  32     800          0.00       98.99    0.99
#  40    1000          0.00       98.99    0.99
#  48    1200          0.00       98.99    0.99
#  56    1400          0.00       98.99    0.99
#  64    1600          0.00       98.99    0.99
#  72    1800          0.00       98.99    0.99
#  80    2000          0.00       98.99    0.99
# ✔ Saved pipeline to output directory
# ja_textcat_wrap_trf/model-last
どうやら正しく動いているみたいです。検証結果を見てみましょう。
!python -m spacy evaluate ./ja_textcat_wrap_trf/model-best ./dev.spacy --output ./test_metrics_ja_textcat_wrap_trf.json \
  --gpu-id 0 --code wrap_trf.py
# 2021-05-03 05:05:04.527202: I tensorflow/stream_executor/platform/default/dso_loader.cc:49] Successfully opened dynamic library libcudart.so.11.0
# ℹ Using GPU: 0
# ...
#
# ================================== Results ==================================
#
# TOK                 100.00
# TEXTCAT (macro F)   98.99
# SPEED               6823
#
#
# =========================== Textcat F (per label) ===========================
#
#                             P        R        F
# SearchCreativeWork      98.96    95.00    96.94
# RateBook               100.00   100.00   100.00
# SearchScreeningEvent    97.03    98.00    97.51
# GetWeather              99.01   100.00    99.50
# AddToPlaylist          100.00   100.00   100.00
# PlayMusic               98.04   100.00    99.01
# BookRestaurant         100.00   100.00   100.00
#
#
# ======================== Textcat ROC AUC (per label) ========================
#
#                        ROC AUC
# SearchCreativeWork        1.00
# RateBook                  1.00
# SearchScreeningEvent      1.00
# GetWeather                1.00
# AddToPlaylist             1.00
# PlayMusic                 1.00
# BookRestaurant            1.00
#
# ✔ Saved results to test_metrics_ja_textcat_wrap_trf.json
F1(macro) で 98.99 です。つまり、一番良い結果がでたのは結局 BOW でした。そういえば第4回でも同じようなことを言っていた気が。。。 まぁ、でも PyTorch ベースのカスタムモデルを組み込むサンプルはあまり見ないので、ご紹介した意味はあったかもですね(というか、そう思いたい)。
最後にこのカスタムモデルを使って livedoor News Corpus の分類に再挑戦しましたが、 F1(macro) で 70.25 でした。無念です。。。 同じ事前学習モデルでも前回紹介した Transformers の Trainer を使うと何も考えなくても F1(macro) で 95.55 とかでるんですけどねぇ。。。
最後になりますが spaCy と日本語とくれば GiNZA についても触れておきましょう。
6. GiNZA
本記事執筆時点の GiNZA 11 のバージョンは 4.0 です。対応する spaCy のバージョンは 2.3 以上となっており、残念ながら spaCy 3.0 系には未対応になっています。だからダメという話ではなく、GiNZA には
- 学習コーパスに UD_Japanese-GSD v2.6 よりも大規模な UD_Japanese-BCCWJ v2.6 を利用している。
CompoundSplitter,BunsetuRecognizerといった独自コンポーネントにより文節やその主辞を単位とした分析が可能。
など、 spaCy の日本語モデルにないアドバンテージがあるので NLP ライブラリを使ってアプリケーションを構築する立場としては、状況に応じて使い分けでしょうか。 公開されたモデルをそのまま使うなら GiNZA 12, Transformers を利用した学習済みパイプラインを作るなら、出来たモデルの性能次第かと。
7. おわりに
今回は spaCy 3.0 について Transformers を使ったパイプラインの学習の仕方を中心にご紹介しました。次回は Switch Transformer の話でもしようかなと思います。
-
細かい違いや機能追加はちょいちょいあるでしょうが。。。 ↩
-
特定のコンポーネント専用に個別の transformer を持つような設定も可能です。 ↩
-
実際のところは利用する Transformers のモデルに依存する話ですね。 ↩
-
あくまでイメージで説明用に手作業で記述してます。単語分割は Sudachi で分けてる訳でもないですし。あと、Ragged に変換される際に、"[CLS]“, ”[SEP]“等の特殊トークンの特徴量は落としてるんだと思います。 ↩
-
https://github.com/megagonlabs/UD_Japanese-GSD/releases/tag/v2.6-NE ↩
-
spaCy の
init configコマンドによる生成もできるのですが、筆者の試したバージョンではエラーになってしまいました。。。 ↩ -
確か、ここだけ社内の GPU マシンで動かした結果をコピペしてるので、SPEED は気にしないでください。 ↩
-
じつは、あまりよくわかってなかったりします。この辺( https://colab.research.google.com/github/explosion/thinc/blob/master/examples/02_transformers_tagger_bert.ipynb ) を見ながら適当に書いてたら動いた的な。。。 ↩
-
本記事のテストデータでの評価のグラフで GiNZA 4.0 が spaCy 2.3 よりもスコアが低くなっていますが、このスコアを記録したモデルは UD_Japanese-GSD v2.6 で学習したようです。GiNZA の日本語モデルは大規模な UD_Japanese-BCCWJ v2.6 で学習しているので、よりスコアがでるハズです。 ↩