今回は AWS が公開した OSS、Context Ontology Accelerator を読んでいきます。AWS Context という「近いうちに来ることは分かっているが、まだ来ていないもの」が控えている状況で、じゃあ今この OSS に触る意味はどこにあるのか、というあたりを、コードを読みながら棚卸ししてみたいと思います。誰が何を読めるかをどう設計しているのか、Bedrock Knowledge Bases とはどう棲み分けるのか、というあたりも見ていきます。
1. はじめに
今回取り上げるのは Context Ontology Accelerator です。長いので以降は COA と略記します。 AWS が Apache 2.0 で公開している OSS で、業務データからオントロジーを誘導し、 そこを起点に AI エージェントへコンテキストを供給する、という物です。
「オントロジー」という言葉について簡単に説明しておくと、ある領域にどんな種類の物事があって、それらがどう関係するのかを、 機械が処理できる形で書き下したものです。 哲学から借りてきた語ですが、情報科学のほうでは「語彙とその関係」くらいの意味で使います。 「顧客」「注文」があって「注文は顧客を 1 つ持つ」、という類です。
で、この COA の周辺には AWS Context という発表済みだけれど Coming soon のサービス1があって、
「COA のユーザー定義オントロジーの機能は将来 AWS Context のネイティブ機能になる」2と公表されています。
ユーザーの立場からすると、今この OSS に投資するべきかという気分になりますね。
なので今回は「COA を使いましょう」という話ではなく、 AWS Context が来たときに、COA のうち何が残るのかという観点で COA v0.3.03 を見ていくことにします。
ちなみに「COA を使いましょう」に関しては、既に日本語の良い記事が 3 本あります。
- 概念の概観・v0.2.0 の変更点・UI ツアー・グラウンドトゥルース検証 → クラスメソッドの記事4(対象は v0.2.0)
- CDK でのデプロイ手順・前提条件・つまずきどころ →
Zenn の AWS Japan の記事5(タグの指定はなく、2026 年 8 月時点の
mainが対象) - 日本語データでの実機検証・v0.2.2 の多言語検索 → クラスメソッドの記事6(対象は v0.2.2)
デプロイの仕方や画面の操作等に興味のある方は、この 3 本を読んでいただくのがよいと思います。 本記事ではデプロイしての動作検証はおこなわず、内部構造・技術標準・認可設計・AWS サービスの役割分担といったところを掘り下げて行きます。
実際の動作を深追いしない理由は 2 つで、1 つは日本語の扱いにまだ課題が残っていること6。 3 本とも対象は v0.2.2 以前なので現在は改善されている可能性がありますが、本記事では検証していません。 もう 1 つは、AWS Context としてフルマネージドに仕立て直されるとしたら、COA での動作検証の結果がどこまで AWS Context に活きるかを見通せないことです。 なので今回は机上での調査に留めることにしました。
ちなみに、3 本の記事はいずれも us-east-1 で検証を行っていますが、 v0.2.2 では Bedrock のモデル ID がすべてデプロイ設定のキーになったので、 ソースを書き換えずに他のリージョンへデプロイできます7。
それでは、まず AWS Context 側の公表内容を整理していきましょう。
2. AWS Context について公表されていること
COA を読む前に、その先に控えているものの輪郭を押さえておきます。 出典は AWS Context を発表した AWS Machine Learning Blog の記事1と、 COA の GA を告げる What’s New の告知2です。 以降、前者を「AWS Context のブログ記事」、後者を「COA の告知」と呼びます。
Amazon Quick から組織規模へ
AWS Context のブログ記事によると、AWS Context は Amazon Quick を支えているものと同じナレッジグラフの技術を拡張したものだ、とされています8。 Quick 側のグラフはデータセット・ダッシュボード・メタデータをカタログして、 利用パターンから学習するもので、日々数十万人規模のユーザーが触っているものだそうです。
注意点ですが、原文の表現は the same knowledge graph technology であって、the same knowledge graph ではありません。Quick のグラフそのものを組織向けに広げるのか、同系統の技術で別のグラフを作るのかは読み取れないところです。
AWS Context は自動処理だけのサービスではない
また、AWS Context のブログ記事にはこう書かれています。
“Data stewards and curators manage the graph through an intuitive console experience, reviewing inferred relationships, promoting them to production, and attaching domain-specific knowledge like business definitions and usage rules.”
つまり、推論された関係を人がレビューして本番に反映する、
業務定義や利用規則を人が付ける、という人手が介在する前提のサービスだということです。
別の箇所では add new context automatically with AI assistance or explicitly through
manual curation とも書かれているので、自動と手動の併用となるようです。
COA の告知から読み取れる内容
一方、COA の告知にはこう書かれています。
“Context Ontology Accelerator connects to your structured and/or unstructured data sources, and uses AI to draft an ontology; your domain experts review, edit, and approve every element of it.”
COA も全部手作業ではなく、AI が下書きして人が承認する構造です。 そして、COA と AWS Context の接点として COA の告知に以下の 2 文があります。
“Context Ontology Accelerator’s managed, user-defined ontology capability will become a fully managed feature native to AWS Context.”
“Customers who get started with Context Ontology Accelerator to create ontologies will be able to use and manage them with AWS Context.”
明言されているのはこの粒度です。「ユーザー定義オントロジー機能がネイティブ機能になる」 と「COA で作り始めたオントロジーを AWS Context で利用・管理できる」の 2 点だけ。 COA 全体が移行される、とは書かれていません。
では、書かれていない残りはどう考えればよいのか。ここから先は COA v0.3.0 の内容を把握しつつ、 AWS Context に向けて残るものや準備しておくことを考えたいと思います。
まずは COA そのものの形を見ていきましょう。
3. COA のアーキテクチャ概要
COA はAWS の既存サービスを活用して、オントロジーを管理/利用する層を実装したものです。 この章では静的な構造だけを見て、実際にどう動くのかは4 章で説明します。
先に COA 固有の語を 3 つ
構成図に COA 独自の語が出てくるので、先に片付けておきます。
- Namespace :
登録するデータと後述する Role の器です。 COA で構築する資源の多くが、Namespace を単位として管理されます。 異なる組織で同じ言葉を違う意味で用いているようなケースは Namespace を分けて対応することになります。 - Role :
Namespace の中の役割です。利用者は Role を介してデータに触ります。namespace-owner/namespace-maintainer/data-steward/data-analystの 4 つが 用意されていて、Namespace ごとに付与します。 これとは別に、Namespace をまたいで効く Role (以後、プラットフォームロールと記述)が 2 つあります。 全 Namespace を操作できるplatform-adminと、全 Namespace を参照できるplatform-viewerです。 - Grant :
Role とテーブルやカラムを結びつけるものです。 「この Role はこのテーブルのこのカラムまで見てよい」という情報を持ちます。
オントロジーと Proposal も COA 固有の語ですが、これは作られる過程を見たほうが 分かりやすいので4 章に回します。
全体構成
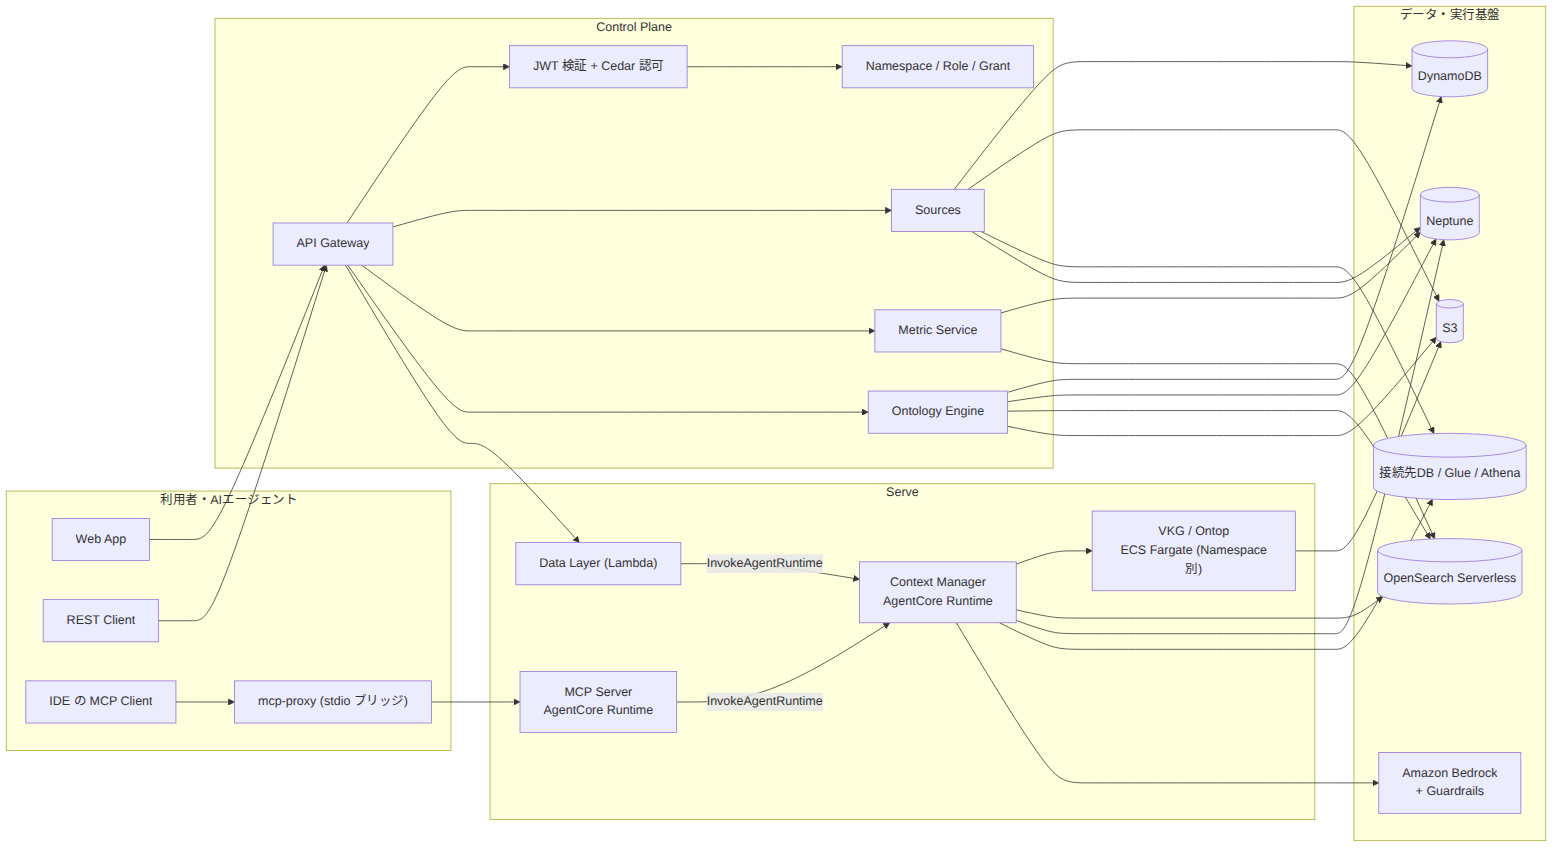
ざっくり説明すると、こうです。
- 利用者は Web App / REST / MCP の 3 経路から入ります。
- Control Plane が API Gateway の下に並ぶ。認証は Cognito ないしは外部の OIDC の発行者が出す JWT、認可は Cedar です。Cedar は AWS が OSS で公開している認可のポリシー言語です9。
- Context Manager と MCP Server は Bedrock AgentCore Runtime の上で動きます。 Data Layer は AgentCore Runtime を呼ぶだけの薄い Lambda です。
- ECS Fargate は 3 通りの使われ方をします。
- Namespace ごとに立つ VKG
- 全体で 1 つ常駐する Ontology Engine
- Step Functions の実行中だけ存在するタスク(DB の Enrichment と文書のグラフ構築)
- データ保存場所は Neptune / OpenSearch Serverless / DynamoDB / S3 / 接続先 DB です。
Control Plane に箱が 4 つ並んでいますが、中身はけっこう違います。 箱は論理的な機能のまとまり(CDK のスタック)だと思ってください。
- Namespace / Role / Grant :
この 3 つを 4 本の Lambda で扱います。/namespaces、/namespaces/{namespaceId}/roles、プラットフォームロールの/roles、 それに/grantsに 1 本ずつ付きます。Role だけ Namespace 単位とプラットフォーム単位で分かれているので 3 つの名前に対して 4 本、という内訳ですね。 状態は全部 DynamoDB で、namespaces/roles/resource-role-mappingsなどのテーブルに入ります - Sources :
データソースの登録とスキャンを扱います。1 本の Lambda の裏に、 DB 用の Step Functions(Discovery の Lambda、Federation の Lambda、Enrichment の Fargate タスク)と 文書用の Step Functions(前処理の Lambda、グラフ構築の Fargate タスク)がぶら下がります。 スキャンの起動と一括レビューは SQS を挟んで非同期です。ソースの登録内容と ジョブの状態は DynamoDB のsources/source-scan-jobsに入ります - Metric Service :
Governed Metric を扱う Lambda 1 本と一括入力用のワーカー Lambda + SQS です。 Governed Metric については後述しますが、データは Neptune と OpenSearch に載ります。 一括入出力の形式は OSI v1.0 です10 - Ontology Engine :
4 つの中で唯一 Lambda ではありません。FastAPI のアプリが ECS Fargate の Service として常駐していて、API Gateway から薄い Lambda が中継します。オントロジーのカタログと埋め込み、誘導、Proposal のレビュー、多段の検証がここです。VKG と違って Namespace ごとではなく、 デプロイに 1 つです
静的な形はこれで一通りです。次の章から、この上でどう動くのかを見ていきましょう。
4. COA の動作 — Scan / Model / Serve
COA の動作は Scan / Model / Serve の 3 つのフェーズに分かれています。
- Scan — 登録したソースから事実を集める。どんなテーブルとカラムがあり、 文書に何が書いてあるか。
- Model — 集めた事実から意味を決める。オントロジーと、テーブルとの対応を作る。
- Serve — 質問に答える。Governed Metric の解決、SQL の生成と実行、文書の検索を行う。
以下、フェーズごとに見ていきます。
Scan — 構造を読んで、業務的な意味を足す。
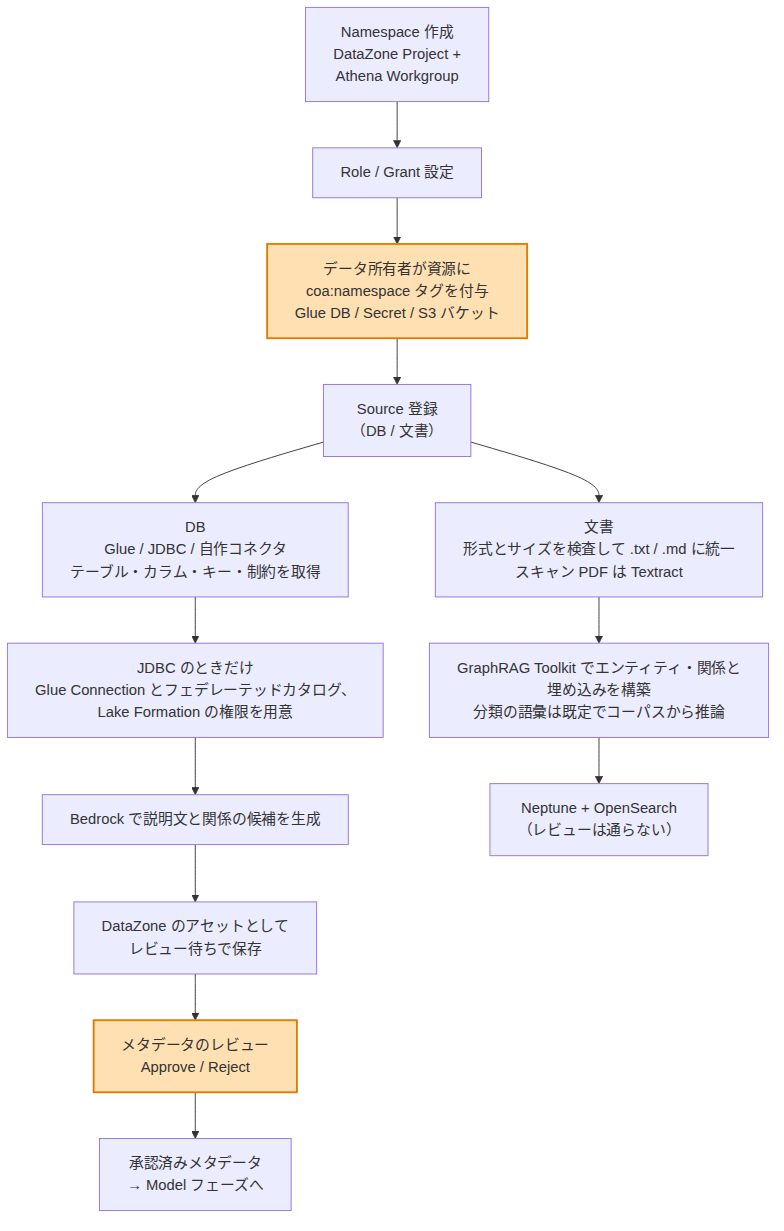
Scan は元データが DB の場合と文書の場合とで通り道が異なります11。
DB の場合
- テーブル、カラム、型、主キー、外部キーを読み取ります。読み取り元は Glue Data Catalog、
JDBC で直接繋いだ DB、それに v0.3.0 で加わった自作コネクタ経由の 3 通りです。
- Glue Data Catalog は、テーブル名・カラム名・型・実データの置き場所といった定義を溜めておく AWS のメタデータの入れ物です。実データそのものは持ちません。 カタログ自体はアカウントとリージョンごとに 1 つで、カタログ ID がアカウント ID になります12。 その 1 つのカタログの中に「データベース」をいくつでも作れるので、 業務の DB を複数並べて登録することができます。 Athena や Redshift はここの定義を見て S3 上のデータに SQL を投げる、という使い方をします。
- JDBC のときだけ、あとで SQL を流すための経路をここで作ります。
Glue の Connection とフェデレーテッドカタログを作って、Lake Formation の
SELECT/DESCRIBEを問い合わせ用のロールに付与するところまで。 既に Glue にあるデータベースなら、カタログは作らず権限の付与だけです。- ここで出てくるフェデレーテッドカタログは、先ほどの 1 つのカタログの下にぶら下がる子のカタログです。 定義の実体は接続先の DB の側にあって、Glue からはそこを覗く形になります。
- Lake Formation は、Glue Data Catalog に登録されたデータベース・テーブル・カラムに対する 権限を、IAM とは別建てで管理する AWS のサービスです13。 IAM が「どの API を呼べるか」を決めるのに対して、Lake Formation は 「どのテーブルのどのカラムを読めるか」をカタログの側で決めます。
- 自作コネクタの経路(
CUSTOM_CONNECTOR)は、v0.3.0 で加わったものです。 Athena Query Federation SDK で書いた Lambda を自分で用意しておいて、 それを Athena のLAMBDA型のカタログとして COA に登録します。 COA 側は Athena にSHOW DATABASES/SHOW TABLES/DESCRIBEを投げて構造を読みます14。 リファレンスのコネクタ(Java)と Databricks SQL Warehouse 向けのコネクタ、 それに手元で動かすための開発キットがconnectors/に同梱されています。 - Bedrock がテーブルとカラムの説明文、それに関係の候補を生成して、
SageMaker Unified Studio(DataZone)のアセットとして書き込みます。
カラムの情報はアセットのフォームに入り、レビューの状態も同じフォームの
reviewStatusに入ります。つまりレビュー待ちのメタデータの置き場は DataZone で、 DynamoDB に入るのはソースの登録内容とスキャンジョブの進行状況です。
一旦、ここで流れが切れます。別途、レビュー待ちになったデータを人がレビューし、状態が APPROVED になると Model フェーズへ入力できる状態になります。
文書の場合
文書はこのレビューを通りません。ここが DB 由来のデータと違うところです。
- 対応形式は
.txt/.md/.docx/.pdfの 4 つで、前処理で.txtか.mdに揃えます。.doc/.pptx/.xlsx/.html/.csvや画像ファイルは非対応で、前処理の段で理由付きで弾かれます。 - PDF は 1 ページあたりの平均文字数を測って、少なすぎればスキャン PDF と判定して
Textract に回します。
- v0.3.0 では、ソースの登録時に
enableTableExtractionを立てると、テキストが取れる PDF も含めて 全ページを Textract のAnalyzeDocumentのTABLESに回すようになりました。 表を Markdown のパイプ表に組み直すので、統計表が文章に潰れずに残ります15。
- v0.3.0 では、ソースの登録時に
- GraphRAG Toolkit が文書を読んで、Neptune にグラフ、OpenSearch に埋め込みとして入れます。
グラフに入るのは、文中に出てきた「もの」(エンティティ)、その分類、
「A が B を〜する」の形に整理した記述、それに文書の話題(トピック)です。
これが GraphRAG Toolkit の言う Lexical Knowledge Graph で、
次の Model フェーズのもう一つの入口になります。
- エンティティの分類に使う語彙は、v0.3.0 から取り込む文書自体から推論するのが既定になりました。
取り込みの頭で LLM に文書を数件サンプルさせて分類のラベルを 15 個ほど作り、それを使って抽出します。
v0.2.2 までは GraphRAG Toolkit の既定のリスト(
Company/Sports Team/Creative Workなど)を そのまま使っていたので、ニュース・金融向けの語彙に引っ張られていました16。 ソースの登録時にpreferredEntityClassificationsで自分の語彙を渡すこともできて、 こちらを指定した場合は推論は走りません。
- エンティティの分類に使う語彙は、v0.3.0 から取り込む文書自体から推論するのが既定になりました。
取り込みの頭で LLM に文書を数件サンプルさせて分類のラベルを 15 個ほど作り、それを使って抽出します。
v0.2.2 までは GraphRAG Toolkit の既定のリスト(
承認を待つ場所がないので、入れたらそのまま Model フェーズへの入力となります。 Lexical Knowledge Graph の人のレビューを通っていないデータが Serve フェーズでどう扱われるかは5 章の認可の話で後述します。
登録できるのは、所有者がタグを付けた資源だけ
DB と文書に共通の話ですが、v0.3.0 の破壊的変更として、
登録するデータソースの側にタグが要求されるようになりました。
Glue のデータベース、JDBC の資格情報を入れた Secrets Manager のシークレット、
文書を置く S3 バケットに coa:namespace のタグを付けて、
値にその資源を使ってよい Namespace の UUID を書いておく、というものです17。
タグが無ければ CreateSource が 400 を返し、v0.3.0 より前に登録したソースも次のスキャンで失敗します。
値は空白区切りで最大 6 個まで並べられるので、1 つの資源を複数の Namespace で共有することもできます。
タグを付けられるのは資源の所有者なので、これは データを COA で利用するにはデータ所有者側の同意を必要とするという条件が追加された形です。
Model — 集めた事実からオントロジーを作る
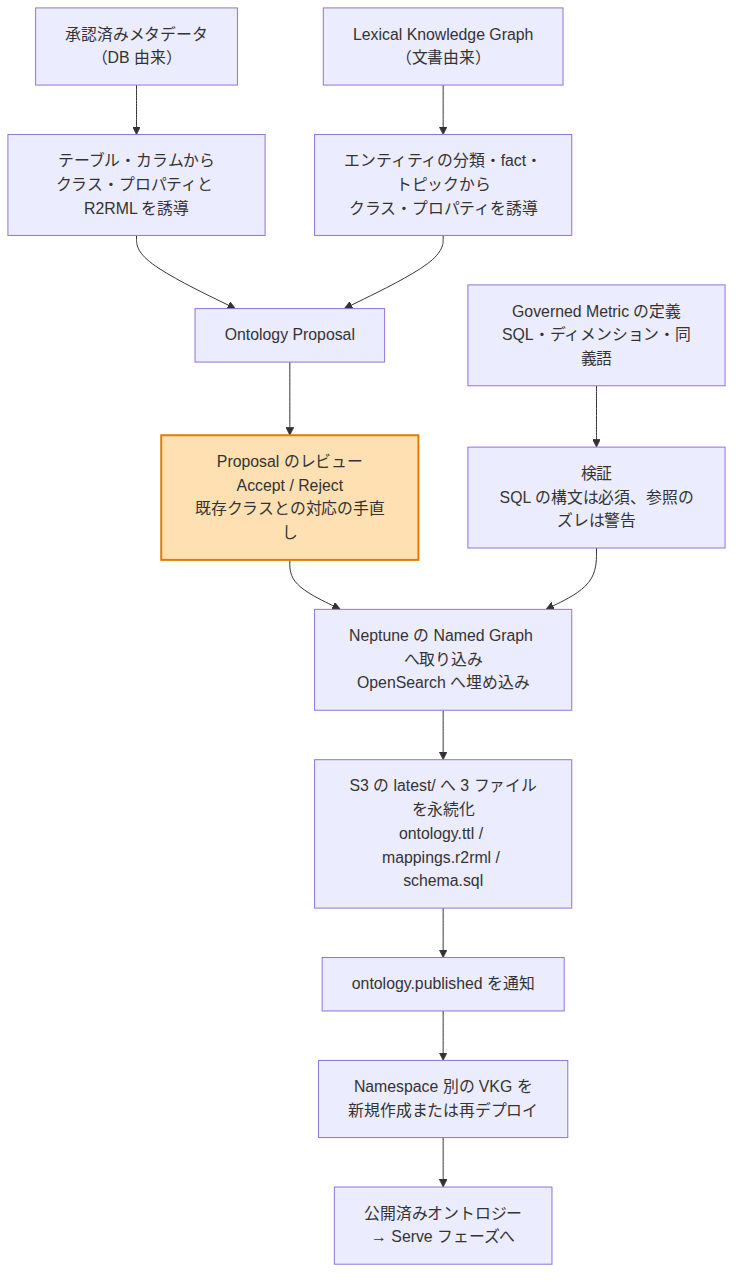
Model でやるのは、Scan で集めたものからオントロジーを作ることです。 入口は 2 つあります。Scan のレビューを通った DB 由来のメタデータと、 文書から作った Lexical Knowledge Graph です。どちらからもオントロジーの案を 組み立てて Ontology Proposal にする、人がレビューして Accept したものだけが公開される、 という流れは共通です。
オントロジーを書くための W3C の標準
Model が作るオントロジーは、W3C の標準に沿ったものです。 AWS Context に引き継がれるかどうかはさておき、W3C の技術標準なので知っておいて損はしないでしょう。
COA がやろうとしているのは 2 つです。オントロジーを表現することと、 そのオントロジーとリレーショナルデータベースの関係を表現すること。
前者に使うのが OWL 218 です。OWL 2 では、オントロジーを次の 4 つで書きます。
- クラス (Class) — 「注文」「顧客」のような、業務で扱う物事の種類
- オブジェクトプロパティ (ObjectProperty) — 「注文は顧客を持つ」のような、 クラスとクラスを結ぶ関連
- データプロパティ (DataProperty) — 「注文は金額を持つ」のような、値を取る属性
- 個体 (Individual) — 「注文 #1234」のような、クラスに属する具体的な 1 つ
オントロジーの本体はクラスと 2 種類のプロパティで、個体は必須ではありません。 実際のデータは DB や文書の側にあるので、そちらを個体として数え上げる必要は無いわけです。
後者に使うのが R2RML19 で、 「このクラスはこのテーブル、このプロパティはこのカラム」という対応を書きます。
この 2 つはどちらも RDF20 という技術がベースです。RDF は、すべてを
「主語・述語・目的語」の三つ組(トリプル)で表す、という決め事だけのデータモデルです。
OWL 2 も R2RML も、その三つ組の上に定義されています。
そして、それをテキストにして S3 に保存するときのシリアライズ形式が Turtle21 です。
.ttl の中身の文法がこれですね。
クラスやプロパティに付ける名前は全部 IRI22 です。URL の形をした識別子、と思って
おけば大体合っています。http://... の形なので、自組織のドメインを使っておけば
他とぶつかりません。
DB のメタデータからオントロジーを誘導する
テーブルがクラス、外部キーのカラムがオブジェクトプロパティ、それ以外のカラムが データプロパティ、という見立てでオントロジーの案を作ります。それに加えて、 どのクラスがどのテーブルなのかという対応(R2RML)も一緒に作り、Ontology Proposal とします。 見るのは承認済みのメタデータだけなので、Scan のレビューを通っていないカラムは案に入りません。 なお、生成が失敗したテーブルは v0.2.2 から理由付きで報告されるようになりました23。
文書からオントロジーを誘導する
文書側の Ontology Proposal には R2RML がありません。対応するテーブルが無いので当然ですが、 そのぶん材料が違います。Scan で作った Lexical Knowledge Graph には、エンティティ、 その分類、「A が B を〜する」の形に整理した記述、トピックが入っていました。 これをオントロジーに読み替えていきます24。
- エンティティの分類が、そのままクラスになります(
owl:Class) - 分類ごとに数件サンプルしたエンティティを、そのクラスの個体として置きます
(
owl:NamedIndividual。任意です) - 「もの」と「もの」を結ぶ記述が、オブジェクトプロパティになります(
owl:ObjectProperty) - 「もの」と値を結ぶ記述が、データプロパティになります(
owl:DatatypeProperty) - トピックは、クラスほど厳密に定義できるものではないので、緩い概念の分類を書くための
SKOS25 という語彙を使って
skos:Conceptにします
出現回数が既定 3 回に届かないクラスは落とします。文書から拾ったものをそのままクラスにすると、 1 回しか出てこない固有名詞でクラスが増えていく一方なので、ここで足切りしているわけです。 説明文の生成と、次に書く既存クラスとの突き合わせに Bedrock を使いますが、 基本的に上のルールで機械的に抽出します。
既存のオントロジーとの突き合わせは 3 通りに分かれます。同じものがあればその IRI を再利用、
近ければ新しい IRI を立てて skos:closeMatch で繋ぐ、まったく新しければ新規に立てる。
判定はベクトルの類似度なので、当然ハズすことがあります。なのでレビューの画面で
「このクラスは既存のこれと同じ」という対応を人が差し替えられるようになっていて、
差し替えると保存済みの Turtle の該当箇所だけを書き換える作りです。
公開されると何がどこに入るか
Ontology Proposal が Accept されると、オントロジーは Neptune の名前付きグラフに取り込まれ、
クラスの埋め込みが OpenSearch に載り、S3 の ontologies/{namespace}/latest/ に
3 つのファイルが書き出されます26。
| ファイル | 内容 |
|---|---|
ontology.ttl |
オントロジーの本体。クラス、プロパティ、論理制約 |
mappings.r2rml |
オントロジーと DB のテーブル・カラムの対応 |
schema.sql |
対応先の DB のスキーマ(テーブルとカラムの定義) |
この 3 つが、Namespace ごとに立つ VKG に読み込まれます。書き出しが終わると
ontology.published のイベントが飛んで、VKG が新規作成または再デプロイされるという流れです。
v0.3.0 では、これとは別に 7 日ごとの再読み込みが EventBridge で走るようになりました27。
VKG
VKG は Virtual Knowledge Graph の略で、中身は Ontop28 という OBDA(Ontology-Based Data Access)の実装です。仕事は、読み込んだオントロジーと DB の対応を使ってグラフへの問い合わせ(SPARQL)を SQL に書き換えること、それだけです。 自分ではデータを持ちません。仮想的なグラフに見えるが実際には DB に問い合わせている、 という意味で VKG と呼ばれます。
schema.sql がなぜ必要なのか
schema.sql だけ、なぜ必要なのかが分かりにくいと思います。テーブル名もカラム名も R2RML に
書いてあるのに、DB のスキーマがなぜ別に要るのか、という話です。R2RML にあるのは
「このプロパティはこのカラム」という対応だけで、そのカラムが本当に存在するのか、
型が何なのか、どれがキーなのかは書いてありません。Ontop はそれを接続先の DB から
読む前提の作りで、読んだ情報でマッピングを検証し、SQL を組み立てます。
ところが COA の VKG は本物の DB に繋ぎません。SQL を実行するのは後段の Athena です。
そこで、同じ形のテーブルだけを空の H2 に作って、それを Ontop に読ませています。
schema.sql はその DDL です。データは 1 行も入っていません。
Governed Metric(業務指標)
Model のフェーズには、もう一つ Governed Metric の登録があります。登録するのは、指標の名前と 同義語、それが何を表す数字なのかという説明、値を導出する SQL、そして月ごと・部門ごとのように 集計を分けたいときに使うカラム(ディメンション)です。「売上」と呼んでいる数字がどのテーブルの どの式なのかを、人が書いて確定させる作業ですね。
Governed Metric は Neptune の中でオントロジーと同じ扱いです。1 つの Governed Metric が owl:Class で、
:GovernedMetric のサブクラスとしてオントロジーと同じ Namespace の名前付きグラフに入ります。
埋め込みも、オントロジーのクラスと同じベクトルインデックスに載ります。
:governedMetricFor でオントロジーのクラスに紐づけることもできます29。
Governed Metric にはレビューがありません。人が書いたものがそのまま定義になるので、 承認する必要がないという判断でしょう。代わりに SQL の構文エラーチェックが入っています。
Serve — 質問に答える
ここまでで準備したデータを使ってユーザーの質問に答えるのが Serve です。
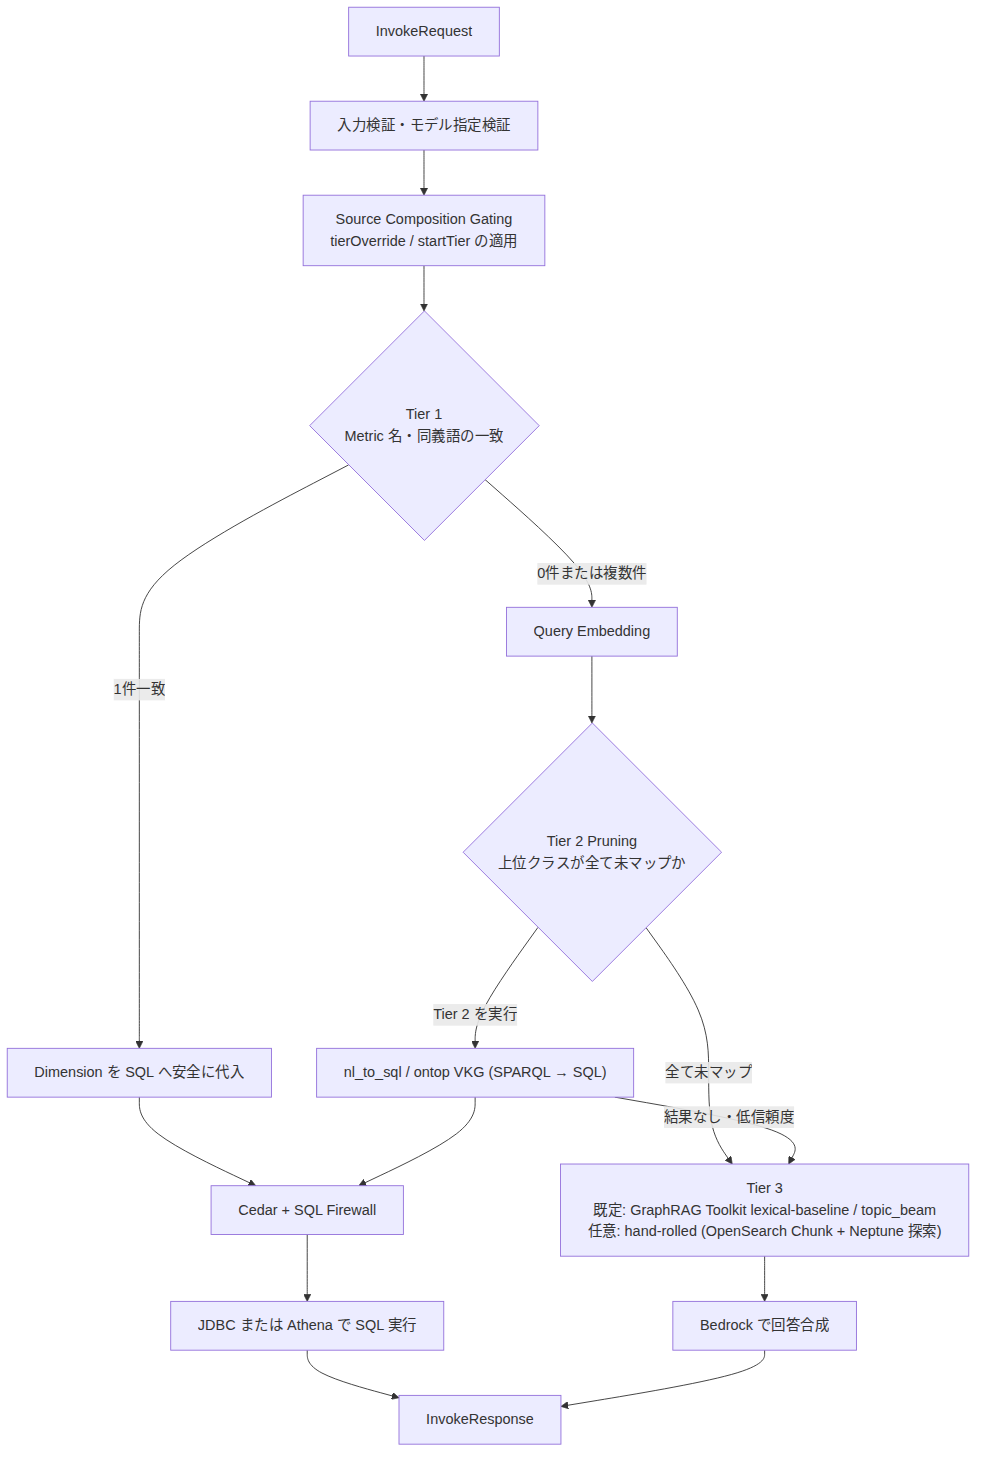
Tier 1 / Tier 2 / Tier 3 の 3 つの経路があり、以下のような Tier 1 → Tier 2 → Tier 3 の逐次フォールスルーになっています。
Tier 1 — Governed Metric の解決 :
質問の中の言葉が、登録済みの Governed Metric の 名前か同義語に一致したら、その定義に入っている SQL をそのまま実行して回答します。一致しない場合は Tier 2 に進みます。Tier 2 — オントロジー経由の SQL 生成 :
質問をオントロジーのクラスとプロパティに対応付けて SQL を生成 (nl_to_sql) 、あるいは一旦 SPARQL を生成し、VKG で R2RML を使って SQL に変換 (ontop) して Athena もしくは JDBC 直結で SQL を実行して回答します。nl_to_sqlとontopのどちらを優先するか、組み合わせるかはリクエストのoptions.strategyで指定できます。既定はnl_to_sqlを試して外れたらontopに落ちるnl_to_sql_firstです30。- 図では省略しましたが、
options.strategyにはこれに加えてdeep-reasoningがあります。表を探してスキーマを見てから SQL を書き、実行してエラーが返ったら書き直す、というループを回すものです31。指定したときだけ動く経路で、他の戦略が外れたときのフォールバック先には入りません。なお、この値は v0.2.2 ではagenticという名前でした32。 - SQL が生成できなかった、SQL の実行が失敗した、回答の確信度が下限を下回っていた場合は Tier 3 に進みます。
Tier 3 — 文書の検索 :
質問をベクトルにして OpenSearch のチャンクを引き、Neptune のグラフから関連するエンティティと関係を辿り、Governed Metric の一覧も材料に加えて回答します。- 検索対象の文書は人のレビューを通っていないので、この経路は承認されていない情報も参照します。 代わりに、回答には根拠にしたチャンクが
supportingContentとして付いてくるので、出典に当たって確かめることはできます。
- 検索対象の文書は人のレビューを通っていないので、この経路は承認されていない情報も参照します。 代わりに、回答には根拠にしたチャンクが
また、逐次フォールスルーではない deep-reasoning モードも選べます。これも図には入れていません。こちらはリクエストの options.mode で、ひとつ上に書いた Tier 2 の options.strategy とは別の指定です。同じ deep-reasoning という名前ですが、動くものが違います。この場合は Tier 1, Tier 2 をとばして最初から Tier 3 のエージェントに処理を渡します。使用可能なツールには標準の Tier 3 の文書のチャンク検索とグラフ探索のほかに Tier 2 相当の処理をする nl_to_sql と nl_to_sparql も入っているので33、業務 DB に SQL を投げることもあります。
「売上のデータと契約書を突き合わせて問題点を説明して」のように、複数の情報源を組み合わせないと答えられない質問に向いた経路ですね。
さて、ここまででオントロジーを整備してそれを利用する流れを押さえましたが、COA に組み込まれた認可処理についても見ておきましょう。
5. COA の認可処理
企業内で AI エージェントにコンテキストを供給する場面では「誰が何を読めるか」は非常に重要になってきます。 COA ではどのような扱いになっているのか、DB 側と文書側で処理が異なるのでそれぞれ見ていきましょう。
DB 側
DB を検索する時の認可処理の流れは二段階になっています。
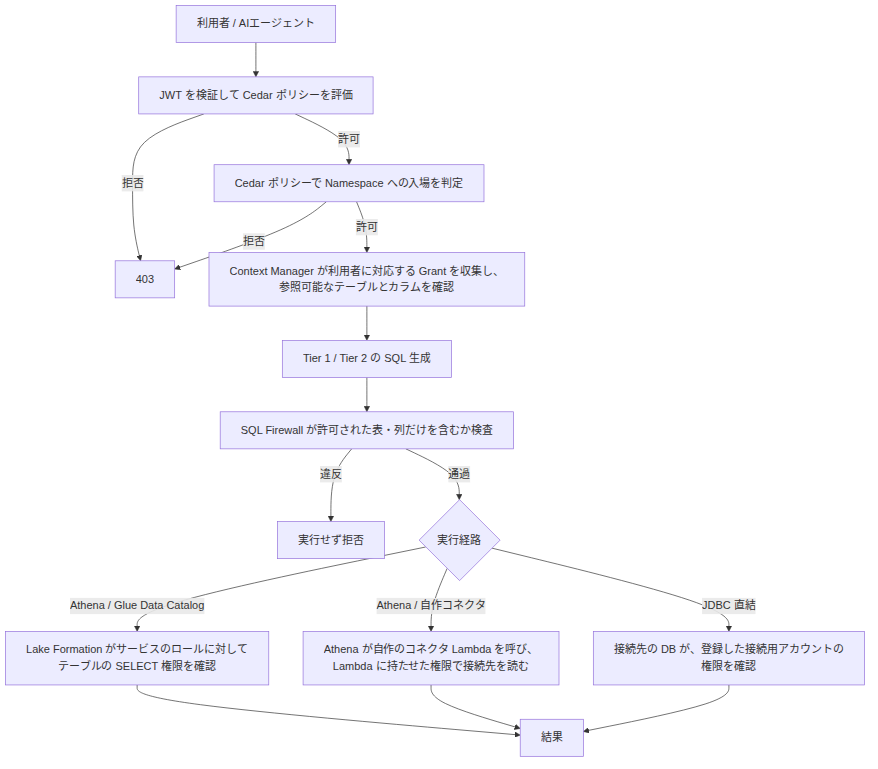
- API の操作の認可 — 利用者の JWT34 を Lambda Authorizer が検証して、
Cedar のポリシーで API の操作可否を決めます。粒度はアクション単位です。
アクションというのは
query(問い合わせ)、searchDocuments(文書検索)、manageSource(データソースの操作)のような、COA の API の操作ひとつひとつに付いた名前です35。 データ範囲の認可 — Context Manager が、呼び出した利用者に対応する Grant を収集して、 参照できるテーブルと、禁止されたカラムを確認します。SQL を組んだあと SQL Firewall が 「許可された表と列だけを含むか」を検査します
- データ範囲を決める Grant は DynamoDB の
resource-role-mappingsテーブルの 1 行です。 Grant の中身は Namespace / Principal(認可の主体)/ Role + 任意のtableAllowlist/columnDenylist/allowedMetricsです。 - Principal には
User/Group/Agentの 3 種類がありますが、 ここでは利用者の JWT のsub、emailクレームをUserの識別子、それにグループのクレームからGroupの識別子として Grant を検索します。 tableAllowlist/columnDenylist/allowedMetricsはそれぞれ参照可能なテーブル、参照禁止のカラム、参照可能な Governed Metric のリストです。- 設定なしと空リストの設定が別物で、例えば
tableAllowlist設定がなければ全て許可。明示的に空のリストを設定すると「1 つも許可しない」になります。 - Grant を検索した結果、利用者に複数の Grant が紐ついていた場合のマージは、 制限が緩む方向には働かないようになっています36。認可の話なので、少し細かく書いておきます。
tableAllowlistとallowedMetricsは、リストを設定している Grant だけの和集合です。 どの Grant にもリストがなければ制限なし。1 つでもリストを設定した Grant があれば、 設定されたリストの和集合だけが許可されます。リストのない Grant が「全部許可」を持ち込むわけではありません。 明示的な空リストも「設定した」側に数えます。columnDenylistは素直に和集合で、どれか 1 つの Grant が禁止したカラムは禁止されます。- マージに入るのは対象の Namespace に付いた Grant だけで、
platform-adminやplatform-viewerのような 全 Namespace 向けの Grant は参加しません。 - 行レベルの制御は入っていません37。
- データ範囲を決める Grant は DynamoDB の
要するにユーザーもしくはユーザーの所属グループの粒度でテーブル、カラム、Governed Metric に対してアクセス制御が可能になっています。
COA での Lake Formation の使い方
先ほどの図で Lake Formation に言及しているので、その使われ方についても補足しておきましょう。 認可という意味では、COA の Lake Formation は利用者単位の認可には関与しません。
では COA では何に使用されているのか? という話になりますが、 まず前置きとして、Glue Data Catalog には 2 つのモードがあります。
- IAM モード —
IAM_ALLOWED_PRINCIPALSが付いている状態。IAM のglue:Get*だけで読めます - Strict-LF モード — それを外した状態。IAM の権限に加えて
Lake Formation の
DESCRIBE/SELECTの付与が必要です
そして Scan フェーズにおいて、収集対象のデータソースが Glue Data Catalog であり、
それが Strict-LF モードに設定されていて AccessDenied が発生したら、
Scan / Serve を担う IAM ロールにそれぞれテーブルの DESCRIBE / SELECT 権限を設定します38。
これだけです。なので Lake Formation は COA がサービスとして対象のテーブル定義を把握、 内容を検索できるように使用されているだけになります。
もう一点、先ほどの図で経路を分けたところですが、Lake Formation が効くのは Glue Data Catalog を 経由する Athena 側だけです。JDBC で接続先の DB に直結する経路では、データソースの登録時に 設定した接続用アカウントの資格情報を Secrets Manager から取り出して SQL を流すので39、 DB 側で効くのはそのアカウントに与えた権限です。利用者ごとの絞り込みは、 どちらの経路でも Grant と SQL Firewall の側で行われている、という構造ですね。
文書側
まず、その Namespace に入ってよいかの判定があります。文書のチャンク検索 (kbSearch) 、
グラフ探索 (graphTraverse) 、質問の変換 (translate) 、それに Tier 3 の経路全体に対して、
リクエストで指定した Namespace に対し query を許す Role
(data-analyst など)を、利用者が保持しているかがチェックされます40。
ただし、判定はここまでです。Namespace の中で、検索対象の文書を利用者ごとに選別する機能はありません41。
文書の「読める」「読めない」は Namespace を分割して制御することになります。 実際の業務適用を考えるとここの制御は少し粗いように感じるので、本格導入を検討する際の障壁になりそうですね。
さて、これで COA について一通りの説明をしました。 ここから AWS Context へつなげる話をしようと思ったのですが、 認可制御の話が出たついでに少し寄り道して、 COA と被る領域を担うサービスである Bedrock Knowledge Bases との比較をしてみたいと思います。
6. Bedrock Knowledge Bases とどちらを選ぶか
Amazon Bedrock の Knowledge Bases は、企業内の文書や業務 DB をエージェントから引けるようにする マネージドサービスです。 COA と全部が重なるわけではありませんが、「社内のデータをエージェントに読ませる」という目的は同じなので、 要件によってはこちらのほうが良い、ということが起こりえます。
まず、Knowledge Base を作るときは type に MANAGED / VECTOR / SQL / KENDRA のどれかを指定します42。
順に Managed Knowledge Base、Customer-managed Knowledge Base、
構造化データストアに接続するもの、Amazon Kendra の索引を借りるものです。
ただし Kendra は 2026 年 6 月末でメンテナンスモードに入り、7 月末で新規のお客様の受付も終了しています43。
これから作るものの選択肢としては外れるので、本記事では扱いません。
残る 3 つは横に並ぶ関係で、機能の差がけっこう大きいので順に見ていきます。
Managed Knowledge Base(MANAGED)
Managed Knowledge Base は埋め込みの置き場まで Bedrock が持つもので、 取り込み元として次の 10 個のコネクタが用意されています44。
- Amazon S3
- Box
- Confluence Cloud
- Confluence Data Center
- Microsoft SharePoint Online
- Google Drive
- Microsoft OneDrive
- ServiceNow
- Web Crawler
- 自分で流し込む Custom connector
埋め込みモデルも再ランクのモデルもサービス側のものが既定で付いてきます。 埋め込みモデルは自分で選んだ Bedrock のものに差し替えられますが、 そうするとサービス側の再ランカーは使えなくなります44。 文書の種類に応じた解析の切り替え(Smart Parsing)、質問を分解して複数回検索する Agentic Retrieval、 それに AgentCore Gateway に対応しています。
Customer-managed Knowledge Base(VECTOR)
こちらはベクトルストアを自分で用意するものです。取り込み元の選択肢は Managed より少なくなりますが、 埋め込みの置き場を選べます45。
- OpenSearch Serverless
- OpenSearch のマネージドクラスタ
- Aurora PostgreSQL
- S3 Vectors
- Neptune Analytics
- Pinecone
- MongoDB Atlas
- Redis Enterprise Cloud
置き場に Neptune Analytics を選ぶと、ナレッジグラフも使えます。取り込みのときに 基盤モデルが文書からエンティティと関係を抜き出してグラフを作り、検索のときは まずベクトル検索でチャンクを当てて、そのチャンクに紐づくノードからグラフを辿って 周辺のチャンクを足す、という動きになります46。
この機能はドキュメント上 GraphRAG と呼ばれています。ただし、ユーザーガイド47によると、 取り込み元は S3 だけ、グラフの作り方には手を入れられません。 ここが COA との一番の違いだと思います。Knowledge Bases のグラフは検索の精度を上げるためのもので、 COA のように業務上の語彙を誰かがレビューして承認するものではありません。 ただ、それだけ運用時の手間がかからないとも言えます。
なお、Managed との差はユーザーガイドにこう書かれています48。
“Note that several capabilities such as third-party connectors, document-level permissions and native AgentCore Gateway integration are only available for Managed Knowledge Bases.”
つまり Box や ServiceNow のような新しめのコネクタ、文書単位の権限制御、 AgentCore Gateway との連携は Customer-managed では使えません。 取り込み元として使えるのは S3 / Confluence / SharePoint / Salesforce / Web クローラ / Custom で、 Confluence / SharePoint / Salesforce を選ぶとベクトルストアは OpenSearch Serverless に限定されます49。 ベクトルストアを自分で持つ代わりに、周辺の作り込みは自分でやることになります。
ただ、Gateway の話は Gateway の target として選べないというだけです50。
Retrieve などの API をエージェントから直接呼ぶのは変わらずできますし、
その呼び出しを Lambda に包んで Gateway の Lambda ターゲットにすれば MCP のツールとして出せます51。
Managed のほうは、それを書かずに済むということですね。
構造化データストアへの接続(SQL)
DB の検索も Knowledge Bases で可能です。type に SQL を指定したものがそれで、
文書を取り込みませんし、埋め込みも作りません52。問い合わせのたびに DB を直接引きます。
クエリエンジンは Redshift Serverless か Redshift Provisioned で、
そこから引ける先は Redshift の中のデータか、4 章で触れた Glue Data Catalog に
登録したテーブルです。後者はアカウントの Glue Data Catalog に直接登録されているものに限られていて、
COA が JDBC 接続のときに作っていたようなフェデレーテッドカタログは想定されていないようです53。
COA の Tier 2 と目的は同じですね。
認可はどうなっているか
Managed Knowledge Base には ACL awareness という機能があります。
取り込みのときに、その文書を読めるユーザーとグループを本文と一緒に入れておいて、
検索のときに利用者のコンテキストで絞る仕組みです。
SharePoint など一部のコネクタでは、元のシステムに問い合わせて今の権限を確認することもできます。
ただしドキュメントには ACL awareness is not authorization とはっきり書かれていて54、
利用者の身元を保証するのはアプリ側の責任、という位置づけです。
それでも、5 章で見た COA の文書検索が Namespace の分割しか持たないのとは粒度が違います。
DB 側は逆です。Knowledge Bases も SQL を実行するのはサービスロールで、
Redshift に IAMR:<サービスロール名> のユーザーを作って GRANT SELECT、
Glue Data Catalog 経由なら Lake Formation の Describe / Select をサービスロールに付与する、という手順になっています53。
つまり利用者ごとにテーブルやカラムを狭める仕組みは Knowledge Bases にはありません。COA の Grant と SQL Firewall に当たるものが無いわけです。
文書は Knowledge Bases のほうが細かく絞れて、DB は COA のほうが細かく絞れる、という対照になっています。
どちらを向くか
できることを軸にして 4 つを並べてみます。
| COA | Managed(MANAGED) |
Customer-managed(VECTOR) |
構造化データストア(SQL) |
|
|---|---|---|---|---|
| 文書を検索できる | ○ | ○ | ○ | ✕ |
| ナレッジグラフを辿れる | ○ | ✕ | ○(Neptune Analytics) | ✕ |
| DB に自然言語で問える | ○ | ✕ | ✕ | ○ |
| 定義済みの指標を決定論的に返せる | ○(Governed Metric) | ✕ | ✕ | ✕ |
| 文書を利用者ごとに絞れる | ✕(Namespace 単位) | ○(ACL awareness) | ✕ | — |
| DB を利用者ごとに絞れる | ○(Grant + SQL Firewall) | — | — | ✕ |
| 1 つの質問に文書と DB の両方を材料にできる | ○ | ✕ | ✕ | ✕ |
| オントロジーを人がレビューして承認できる | ○ | ✕ | ✕ | ✕ |
| エージェントに繋ぐ経路 | 同梱の MCP Server | AgentCore Gateway のコネクタ | Retrieve を呼ぶか Lambda を書く |
RetrieveAndGenerate を呼ぶか Lambda を書く |
| 運用の負荷 | 高 | 低 | 中 | 低 |
列の 3 つは Knowledge Base の type です。
「1 つの質問に文書と DB の両方を材料にできる」は、1 回の問い合わせで文書のチャンクと業務 DB の
両方を回答の材料にできるか、という意味です。COA だと deep-reasoning モードのエージェントが
文書のチャンク検索・グラフ探索・nl_to_sql を同じ場で持っているのでこれができます。
Knowledge Bases 側は 1 つの Knowledge Base が文書か DB のどちらかなので、そこはアプリ側で
束ねることになります。ただ Managed の Agentic Retrieval は 1 回の呼び出しで複数の
Knowledge Base を相手にできるので55、文書側だけなら横並びの複数を引けます。
要するに、COA を選ぶ理由は業務の言葉を自分たちで定義して、それを人が承認した状態で保てるところ だと思います。 ただそれは、オントロジーを書いてレビューして直し続ける手間と引き換えです。 表の「運用の負荷」が高いのは、機能が多いからというより、人が回す前提の仕組みだからですね。
逆に Knowledge Bases を積極的に選ぶ理由になりそうなのは、文書検索で文書単位の細かい制御が必要なとき でしょうか。ACL awareness に当たるものは COA にはありません。 それ以外は、機能的に Knowledge Bases で足りるなら運用の手間の軽いそちらを選ぶ、 という判断で良い気がします。
では、本筋に戻って AWS Context へ向けての準備の話です。
7. AWS Context に持ち出せるものと、今から準備できること
COA の中身はここまでで見終わりました。ここからは、このうち何を AWS Context の側へ 持ち出せるのかの棚卸しです。公表内容から推測できることと、関連する AWS サービスの視点から、COA から持ち出せるもの、今から準備できることを整理しておきましょう。
公表されている 2 点と、そこから推測できること
公表されている事実は 2 点です。
- COA のユーザー定義オントロジーの機能は AWS Context のフルマネージドのネイティブ機能になる
- COA で作り始めたオントロジーを AWS Context で利用・管理できる
ただ、フルマネージドになるのは「動かす仕組み」の話です。 オントロジーを人が承認する手間は AWS Context にも引き継がれ、 そこはフルマネージドになっても軽くならないでしょう。というか、個人的には「手間を掛けてオントロジーを整備・保守する仕組み」にこそ価値があるのではないかと思っています。
分からないのはオントロジーの中身の形式です。AWS Context の内部が OWL 2 や R2RML なのかは公表されていません。 期待できるのは、それらで表現できるものと同等の内容が保たれる、というところまででしょう。
それと、AWS Context のブログ記事では、 問い合わせが呼び出しユーザーの IAM と Lake Formation の権限を継承する設計だとされています1。 Lake Formation が効くのは Glue Data Catalog に登録された資源なので、 Glue Data Catalog が絡むのはほぼ必然です。 つまり R2RML かどうかは別として、オントロジーを起点に DB を引く経路自体は残る公算が大きいと思います。
AWS サービスの棚卸し
次に AWS サービスについて考えましょう。COA が依存している代表的なサービスを並べて、それが AWS Context の構成要素として再利用されそうか、という観点での整理です56。
| AWS サービス | 一般的な役割 | COA v0.3.0 での役割 | AWS Context のブログ記事での扱い | 構成要素になりそうか |
|---|---|---|---|---|
| AWS Glue Data Catalog | テーブル定義とスキーマのカタログ | 構造化ソースのメタデータ取得元 | AWS Context の節。ナレッジグラフと統合するサービスとして名指し | 高い |
| AWS Lake Formation | カタログ資源への権限付与 | 自分自身の IAM ロールへのテーブル権限を自己付与 | AWS Context の節。統合先として名指し。加えて、各呼び出しが呼び出しユーザーの IAM と Lake Formation の権限を継承する設計だと記述 | 高い |
| Amazon SageMaker Unified Studio | データとモデルの統合作業環境 | Namespace ごとに DataZone の Project を作る | AWS Context の節。統合先として名指し | 高い |
| Amazon Athena | S3 とフェデレーション先へのクエリ実行 | Tier 1 / Tier 2 の SQL 実行経路 | AWS Context の節。ただし公開されたメタデータを引く側のエンジンの例として、Redshift や Spark と並んで名前が出るだけ | 不明 |
| Amazon Bedrock AgentCore | エージェント実行基盤 | Context Manager と MCP Server の実行環境 | AWS Context の節。ただしグラフを問い合わせるエージェント側の例として、EKS や MCP 互換のフレームワークと並んで名前が出るだけ | 不明 |
| Amazon Bedrock | 基盤モデルの提供 | オントロジー誘導と回答合成、Guardrails 2 種 | 言及なし | 高い(LLM を使わない構成は考えにくい、という筆者の判断) |
| Amazon Neptune | グラフデータベース | 公開済みオントロジーの正本 | 言及なし | 不明 |
| Amazon OpenSearch Serverless | ベクトル・全文検索 | クラス埋め込みと文書チャンク | 言及なし | 不明 |
| Amazon DynamoDB | キーバリューストア | Namespace / Role / Grant / ジョブ状態 | 言及なし | 不明 |
| Amazon Textract | 文書の OCR | スキャン PDF のテキスト抽出と、任意で PDF の表抽出 | 言及なし | 不明 |
Lake Formation だけ補足します。5 章で見たとおり、COA での使い方は サービス自身のロールにテーブルの権限を自己付与するところまでで、利用者単位の認可には関与しません。 一方 AWS Context は呼び出しユーザーの権限を継承する設計とされているので、同じサービスが、サービス単位の権限付与から利用者単位の認可へと、より高いレベルで使われることになりそうです。
持ち出せるもののまとめ
オントロジー自体を AWS Context で利用・管理できることは公表されている事実です。 そこから先を含めてまとめると、持ち出せるのはこのあたりだと思います。
- オントロジーとテーブル・カラムの紐付け — オントロジーを起点に DB を引く経路が残るなら、 これも何らかの形で残るはずです
- Governed Metric — オントロジーの語彙で書いた指標の定義と SQL です。 利用者が手数を掛けて整備した資産なので、経路が残るなら維持される側ではないでしょうか
- テーブル・カラムへのアクセス制限 — 制限を適用する責務は Lake Formation に寄るのではないでしょうか。
ただ、COA の Grant の設定がそのまま移行されるのか、AWS Context の側で設定し直すことになるのかは
公表されていません。Grant には
Agentの Principal やallowedMetricsのように Lake Formation にそのまま対応するものがない部分もあるので、設定の持ち越しまでは期待しないほうが安全だと思います - Namespace の論理分割 — 同じ言葉を違う意味で使う組織を分けるという、 オントロジー側の都合から来るものなので、何らかの形で残りそうです
- Glue / Lake Formation / SageMaker Unified Studio の理解と、レビュー承認の運用体制 — これらの知見や体制などは持ち越せるのではないでしょうか。
さて、COA から AWS Context へという流れとは別に、同時期に発表された新機能について、オントロジーという概念と関係がありそうな部分についても、少し整理しておきましょう。
業務上の意味を書ける場所
先ほどの表には入れませんでしたが、同じブログ記事には AWS Context とは別に 2 つの発表が載っています。
1 つは AWS Glue Data Catalog Business Context and Semantic Search の preview です1。 Glue のテーブル・ビュー・カラムに業務的な説明、glossary terms、カスタムメタデータを付けられるようになり、 新しい Glue Search API で業務的な意味からデータを探せるようになります。加えて skill assets という 新しい asset type(AI スキルやランブックの URI をデータ資産に紐づけるもの)も preview で挙がっています。
もう 1 つは Amazon S3 Annotations の GA です1。S3 のオブジェクトに名前付きのテキストを
後付けできる機能で、1 オブジェクトバージョンあたり 1,000 件、ペイロードは 1 件 1 MiB まで57、
合計で 1 GiB までです58。書き込みはアップロードとは別の PutObjectAnnotation で行います。
業務上の意味を置ける場所がまた増えました。COA が定義するものを含めて数えると、 「データに業務上の意味を書ける場所」が現時点で 5 箇所あります。
| 置き場 | 書けるもの | COA v0.3.0 での扱い |
|---|---|---|
| DataZone のアセットとフォーム | テーブル・カラムの説明、同義語、タグ、レビュー状態 | COA が自身のデータを管理するために作る箱。Bedrock が推測した内容を人がレビューして登録する |
| DataZone の Business Glossary | 業務用語とその定義、用語どうしの関係 | 使っていない |
| Glue Data Catalog のコメントとパラメータ | テーブル・カラムのコメント、パラメータ | 業務メタデータを導出する元として読む。コメントは「決定論的に得られた説明」として承認済みで取り込まれ、Bedrock が生成した説明で上書きされない59 |
| Glue Data Catalog の Business Context | テーブル・ビュー・カラムに対する業務的な説明、glossary terms、カスタムメタデータ、skill assets | 使っていない |
| S3 の Annotation | オブジェクト 1 つに対する名前付きのテキスト | 使っていない |
どこに何を書くべきなのか、どのサービスがどこの情報を参照しているのか、 わからなくなってきそうですね。私も混乱しながら書いているところがあるので、どこに何を書くのが正解かは書けません。
では、これらを踏まえて今やれることに落としてみます。
今から準備できること
- オントロジーの整備 — 「売上」とは何か、どのテーブルのどのカラムで、どの期間の、どの単位なのか。これが一番重要かつ一番時間がかかる作業です。 やり方は 2 通りあって、机上で整理する手と、COA を立てて AI に下書きさせたものを人がレビューしていく手です。 後者は「COA で作り始めたオントロジーを AWS Context で利用・管理できる」が公表されている以上、 そのまま移行の経路に乗る形になります。外部記事で指摘されている日本語の課題は Serve 側、 つまり質問と語彙の照合の話なので、作る側から始めるなら試してみる価値はあると思います60。 いずれにしても地道に進めていきましょう。
- レビュー承認の運用フローと担い手 — 誰が承認するのか。 Data Steward 的な役割を組織の中に作るところまで含めて、運用体制の整備も時間がかかりそうです。
- 業務上の意味を書く場所 — 似たような情報を記述できる場所が複数あるので、同じことが複数の場所に書かれたり、同じ種類の情報があっちこっちに書かれている状態になると厄介です。今のうちにルールを整理しておきましょう。
- Lake Formation をエンドユーザー認可として設計する練習 — AWS Context では呼び出しユーザーの権限を継承する設計に、利用の仕方のレベルが上がります。事前に練習して、設定方法を確認したり、自組織への適用を想定した際の機能上の課題の有無など検証しておくとよいでしょう。
この章の話は根拠の強さがまちまちなので、最後に分けておきますね。
- 【AWS 公表】 ユーザー定義オントロジーの機能がフルマネージドのネイティブ機能になること、 COA で作り始めたオントロジーを AWS Context で利用・管理できること
- 【筆者の推測】 オントロジーとテーブル・カラムの紐付け、Governed Metric、 Namespace の論理分割は何らかの形で残り、テーブル・カラムへの制限は Lake Formation に寄る
- 【未公表】 オントロジーの内部形式、移行の手段、機能の同等性、時期・料金・リージョン
- 【筆者の提案】 上に挙げた 4 つの準備
長々と話をしたわりに一番重要なのは、 COA だの AWS Context だのという技術の話ではなくて、 自組織の中に埋め込まれている概念の整理と、その改善を継続していく体制の整備だという話になりました。 「言われんでも、わかってるわ!」と言われそうな当たり前の話ですが、 自分しか知らないことは他人は助けようがないですし、 時間がかかって大変だけれども、だからこそコツコツ地道になることが重要ということかもしれません。
AI が進化するにつれて、フレームワークだのサービスだの技術者目線でキラキラしたところは、どんどんやることがなくなり、「手間がかかることでも地道に取り組む」あるいは「取り組める」というのが、大事になってくるのだろうなと思いました。
8. おわりに
書き終わって振り返ると、文章の流れが綺麗に収められてない感じがしますね。 正直、私も AWS のこの界隈はあまり触ったことがなく、調べれば調べるほど、何をどう使うのが正解かわからなくなり、あれも気になる、これも気になると盛り込んでいったら、こうなってしまいました。
私と同じ立ち位置のどんなサービスがあるかよく知らない界隈の方には、超ざっくりレベルで、「どんなサービスがあって、どう違うのか」の入口を提示できていればいいのですが。。。
さて、AWS Context がリリースしたら、次は使ってみましたの記事を書けたらいいなと思います。
-
https://aws.amazon.com/blogs/machine-learning/context-intelligence-for-your-data-and-ai-agents-at-scale/ ↩
-
https://aws.amazon.com/about-aws/whats-new/2026/07/aws-context–ontology-accelarator-generally-available/ 該当の原文は “Context Ontology Accelerator’s managed, user-defined ontology capability will become a fully managed feature native to AWS Context.” です。 ↩
-
https://github.com/aws/context-ontology-accelerator/tree/v0.3.0 以降、ファイルパスはこのタグ時点のものです。 ↩
-
https://dev.classmethod.jp/articles/20260817-aws-context-v020/ ↩
-
https://zenn.dev/aws_japan/articles/context-ontology-accelerator-deploy ↩
-
https://dev.classmethod.jp/articles/20260830-aws-context-v022/ ↩
-
https://github.com/aws/context-ontology-accelerator/releases/tag/v0.2.2 Bedrock のモデル ID は SSM のデプロイ設定(
/{prefix}/config)のキーになりました。デプロイ先のリージョンと us-east-1 の両方に CDK の bootstrap が必要です。*-edge-wafスタックは常に us-east-1 にデプロイされるためです。 ↩ -
原文は “extends the same knowledge graph technology that powers Amazon Quick” です。 ↩
-
https://www.cedarpolicy.com/ に言語仕様とプレイグラウンドがあります。COA が同梱しているポリシーは
libs/common/src/coa_authorization/seed/の.cedarファイルです。 ↩ -
https://github.com/open-semantic-interchange/OSI ベンダー中立の指標・セマンティックモデルの仕様です。同じ系統のものが現在は Apache Software Foundation で Apache Ossie (incubating) として開発されています( https://github.com/apache/ossie )が、COA が対象にしているのは改名前の OSI v1.0 です。 ↩
-
infra/lib/stacks/services/sources-stack.tsの Step Functions の定義で確認できます。 ↩ -
https://docs.aws.amazon.com/glue/latest/dg/ の Data Catalog ARNs に
Each AWS account has a single Data Catalog in an AWS Region with the 12-digit account ID as the catalog ID.と書かれています。 ↩ -
https://docs.aws.amazon.com/lake-formation/latest/dg/what-is-lake-formation.html ↩
-
packages/sources/src/coa_sources/database/connectors/custom_connector.pyです。Athena にはGetTableMetadataもありますが、カラムのコメントを返すのがDESCRIBEだけなので SQL のほうを使っています。主キー・外部キーの情報は接続先の DB がコメントに@pk/@fkの形で載せてくる前提で、そこから読み取ります。 ↩ -
packages/sources/src/coa_sources/documents/preprocessing/processors.pyのprocess_pdf_textract_tables()です。ページを 300 DPI の PNG に落としてから 1 ページずつAnalyzeDocumentを呼び、文章の行を先に、表をパイプ表にして後に並べた Markdown に組み直します。 ↩ -
packages/sources/src/coa_sources/documents/kg_build/graph_build.pyの_build_indexing_config()です。既定のリストは GraphRAG Toolkit のgraphrag/indexing/constants.pyのDEFAULT_ENTITY_CLASSIFICATIONSで、11 個のラベルが入っています。推論は同じツールキットのInferClassificationsで、既定は 5 件のサンプル ✕ 1 回で 15 ラベルです。 ↩ -
タグのキーは正確には
{prefix}:namespaceで、prefixはデプロイ時の接頭辞です。既定のデプロイだとcoa:namespaceになります(libs/common/src/coa_common/constants.pyのnamespace_tag_key())。判定はソースの種類ごとに実装が分かれていて、Glue がpackages/sources/src/coa_sources/database/glue_ownership.py、シークレットが同ディレクトリのsecret_binding.py、S3 バケットがpackages/sources/src/coa_sources/api/document_routes.pyの_validate_bucket_namespace_authorization()です。上限の 6 個は Secrets Manager のタグの値が 256 文字までなので、UUID を空白区切りで並べられる数から来ています。COA 自身が作った Glue のカタログ(名前が{prefix}ds_で始まるもの)は所有者が COA なのでタグを要求しません。Glue だけは値にALLと書いて全 Namespace に開くこともできます。シークレットの確認はDescribeSecretだけで、GetSecretValueは呼びません。 ↩ -
InductionReportのdroppedTablesです。テーブル名と理由(gen_llm_empty/parse_failed等)が入ります。packages/ontology-engine/src/coa_ontology/inducer/schemas.pyのDroppedTableです。 ↩ -
packages/ontology-engine/src/coa_ontology/inducer/unstructured/services/induction_rules.pyです。 ↩ -
packages/ontology-engine/src/coa_ontology/proposals.pyの_persist_induced_to_s3()です。 ↩ -
infra/lib/stacks/services/vkg-stack.tsのVkgReloadSweepRuleです。7 日ごとに{ sweep: true }を投げます。 ↩ -
Governed Metric を
owl:Classとして Neptune に書くところはpackages/metric-service/src/coa_metrics/neptune_client.py、検証の一覧と “Author early, validate continuously” は同じディレクトリのvalidator.pyにあります。 ↩ -
packages/context-manager/src/coa_serve/tier2/strategy.pyのStrategyOptionです。値はbest/ontop/nl_to_sql/ontop_first/nl_to_sql_first/deep-reasoningの 6 つで、既定はnl_to_sql_firstです。bestは 2 つを並列に走らせて確信度の高い方を採ります。 ↩ -
packages/context-manager/src/coa_serve/tier2/nl_to_sql/agentic_strategy.pyとpackages/context-manager/src/coa_serve/agents/sql_agent.pyです。ツールは表の検索 (search_tables) 、スキーマの取得 (get_table_schema) 、SQL の生成 (generate_sql) 、実行 (execute_sql) で、explore_graphは任意で足せます。ターン数の上限は持たず、リクエスト全体の期限 (RESOLVE_TIMEOUT_S) と 1 文あたりの実行タイムアウト (SERVE_DEEP_REASONING_EXEC_TIMEOUT_S) で止まります。またexecute_sqlはgenerate_sqlが返したハンドルしか受け取らないので、エージェントが任意の SQL 文を実行することはできません。 ↩ -
options.modeとoptions.strategyの両方で v0.3.0 に改称されました。旧称のagenticもpackages/context-manager/src/coa_serve/tier2/strategy.pyのLEGACY_STRATEGY_ALIASES、packages/context-manager/src/coa_serve/mode.pyのLEGACY_MODE_ALIASESで受け付けられるので、v0.2.2 向けに書いたリクエストはそのまま動きます。環境変数もAGENTIC_*がDEEP_REASONING_*、SERVE_AGENTIC_*がSERVE_DEEP_REASONING_*に変わっていて、旧名はpackages/context-manager/src/coa_serve/config.pyのenv_with_legacy_name()が警告付きで読みます。TIER3_STRATEGYに指定する値も同様です。 ↩ -
名前は
-to-sql/-to-sparqlとなっていますが、SQL の生成だけで終わるのではなく、業務 DB の検索まで行った結果の行が返ります。packages/context-manager/src/coa_serve/tier3/agentic/tools/structured_tool.pyです。 ↩ -
infra/lib/stacks/foundation/idp-authentication-stack.tsです。JWT の発行元はデプロイ時に選べます。Cognito のユーザープールを作る構成、それに SAML のフェデレーションを足す構成、Cognito を作らず外部の OIDC の発行者と JWKS の URL を設定に持つ構成の 3 通りです。グループのクレーム名は構成によって変わります。 ↩ -
全部で 13 個です。
grantPermissions/list/manageMetric/manageNamespace/manageOntology/manageRoles/manageSource/query/readMetric/searchDocuments/translateQuery/traverseGraph/viewNamespaceで、libs/common/src/coa_authorization/seed/の.cedarファイルに書かれています。 ↩ -
packages/control-plane/src/coa_control_plane/grants/create_handler.pyです。Serve 側で引いているのはpackages/context-manager/src/coa_serve/role_resolver.pyで、マージは同ファイルの_restrictive_merge()と_union_of_declared()です。 ↩ -
型の定義は
libs/common/src/coa_common/authnz_types.pyにあり、rowFiltersという型は定義されていますが実装がありません。 ↩ -
Scan が収集対象の Glue Data Catalog において Lake Formation の管理者ロールの権限を持っていない場合、この対応はできないので、データ所有者に実行してもらう
aws lakeformation grant-permissionsのコマンドを組み立ててエラーメッセージに出します。packages/sources/src/coa_sources/database/connectors/lf_grant.pyのlf_onboarding_hint()が該当箇所です。 ↩ -
packages/context-manager/src/coa_serve/clients/source_db.pyです。データソースの設定のcredentialSecretArnから Secrets Manager の資格情報を取り出して接続します。 ↩ -
packages/context-manager/src/coa_serve/main.pyの_authorize_namespace_access()です。Cedar の評価そのものはpackages/context-manager/src/coa_serve/tier2/sql_firewall.pyのauthorize_namespace()で、SQL の検査と同じ関門を共有しています。利用者の識別は同ディレクトリのidentity.pyのresolve_principal()で、JWT のクレームがリクエストのボディに書かれたプロフィールより優先されます。 ↩ -
packages/context-manager/src/coa_serve/tier3/vector_retriever.pyです。引数は埋め込みベクトル、Namespace、top_kの 3 つだけです。 ↩ -
https://docs.aws.amazon.com/bedrock/latest/APIReference/API_agent_KnowledgeBaseConfiguration.html ↩
-
https://docs.aws.amazon.com/kendra/latest/dg/kendra-availability-change.html ↩
-
https://docs.aws.amazon.com/bedrock/latest/userguide/kb-managed-create.html#kb-managed-connectors ↩
-
https://docs.aws.amazon.com/bedrock/latest/APIReference/API_agent_StorageConfiguration.html ↩
-
https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base-build-graphs.html#knowledge-base-build-graphs-works ↩
-
https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base-build-graphs.html#knowledge-base-build-graphs-considerations ↩
-
https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base.html ↩
-
https://docs.aws.amazon.com/bedrock/latest/userguide/data-source-connectors.html ベクトルストアの制約は https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base-create.html に “If your data source is a Confluence, Microsoft SharePoint, or Salesforce instance, the only supported vector store service is Amazon OpenSearch Serverless.” と書かれています。 ↩
-
https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/gateway-target-connector-managed-kb.html ↩
-
https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/gateway-add-target-lambda.html ↩
-
https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base-build-structured.html ↩
-
https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base-prereq-structured.html ↩
-
https://docs.aws.amazon.com/bedrock/latest/userguide/kb-managed-acl.html ↩
-
https://docs.aws.amazon.com/bedrock/latest/APIReference/API_agent-runtime_AgenticRetrieveStream.html です。
retrieversは 1 件以上の配列で、上限は書かれていません。 ↩ -
判断材料にするのは AWS Context のブログ記事の本文だけです。ページの周辺にサービス名が表示されていても、AWS Context の構成要素として明言されたことにはならないので、そこは「言及なし」にしています。そして言及がなければ構成要素になるかどうかは「不明」で、使われないと分かっている、という意味ではありません。また、表に挙げたのは主要なものだけです。 ↩
-
https://docs.aws.amazon.com/AmazonS3/latest/API/API_PutObjectAnnotation.html ↩
-
https://docs.aws.amazon.com/AmazonS3/latest/userguide/annotations-overview.html ↩
-
packages/sources/src/coa_sources/database/connectors/glue_catalog.pyです。Glue のコメントが入っていた場合はenrichment_sourceをDETERMINISTIC、review_statusをAPPROVED、confidenceを1.0にして取り込みます。 ↩ -
とはいえ、誘導の側にも ASCII 前提の処理は残っています。クラスの局所名は
to_pascal()が英数字以外を落として作るので、テーブル名が日本語だとEntityに潰れ、衝突したぶんにEntity_xxxxxxxxと判別子が付きます(packages/ontology-engine/src/coa_ontology/inducer/strategies/base.py)。ラベルのほうは残るので読めなくなるわけではありませんが、URI は英字のテーブル名を前提にした作りです。 ↩